0%

RPC(Remote Procedure Call) 远程调用

RPC原理

可以分为五个部分实现

  1. 客户端(服务消费端): 调用方法的一端
  2. 客户端Stub(桩):代理类,将调用的方法、类、方法参数作为信息传递到服务端
  3. 网络传输: 将信息传输到服务端,并且将返回结果发挥给调用端,推荐使用Netty
  4. 服务端Stub: 接收信息,去执行对应的方法,将结果返回
  5. 服务端(服务提供端): 提供服务的一端
    过程:
  6. 服务消费端client以本地调用的方式去调用远程服务
  7. 客户端Stub (client stud) 接收调用后将方法、参数等组装进能够进行网络传输的消息体(序列化之后) : RpcRequest
  8. 客户端Stub 找到远程服务的地址,将消息发送到服务提供端
  9. 服务端Stub 收到消息后,反序列化为RpcRequest 对象
  10. 服务端Stub 根据RpcRequest中的类,方法,方法参数等信息调用本地方法1
  11. 服务端Stub 将得到的结果封装为 RpcResponse序列化后发送给消费方
  12. 客户端Stub接收消息并将其反序列化为RpcReponse

Invoker是什么

Inboker 是Dubbo对远程调用的抽象

Dubbo 的SPI机制

SPI (Service Provider Interface):将接口的实现放在配置文件中,在程序的执行过程中读取配置文件,通过反射加载实现类。也就是提供接口,允许第三方实现这个接口

Dubbo 的微内核架构

微内核架构模式又名插件架构模式,是基于产品应用程序的一种自然模式。允许用户添加额外的应用到核心应用。例如IDE

Dubbo的负载均衡策略

设计模式

设计模式是⼀套被反复使⽤的、多数⼈知晓的、经过分类编⽬的、代码设计经验的总结。

设计模式的原则

  1. 开闭原则:对扩展开放,对修改关闭
  2. 单一职责原:一个类只负责一个功能领域中的相应职责
  3. 里氏替换原则:所有引用基类的地方必须能透明地使用其子类对象
  4. 依赖倒置原则:以来月抽象,不能依赖于具体实现
  5. 接口隔离原则:类之间的依赖关系应该简历在最小接口上
  6. 合成/聚合复用原则:尽量使用合成/聚合,而不是通过继承达到复用的目的。
  7. 迪米特法则:一个软件实体应该尽量少的与其他实体发生相互作用

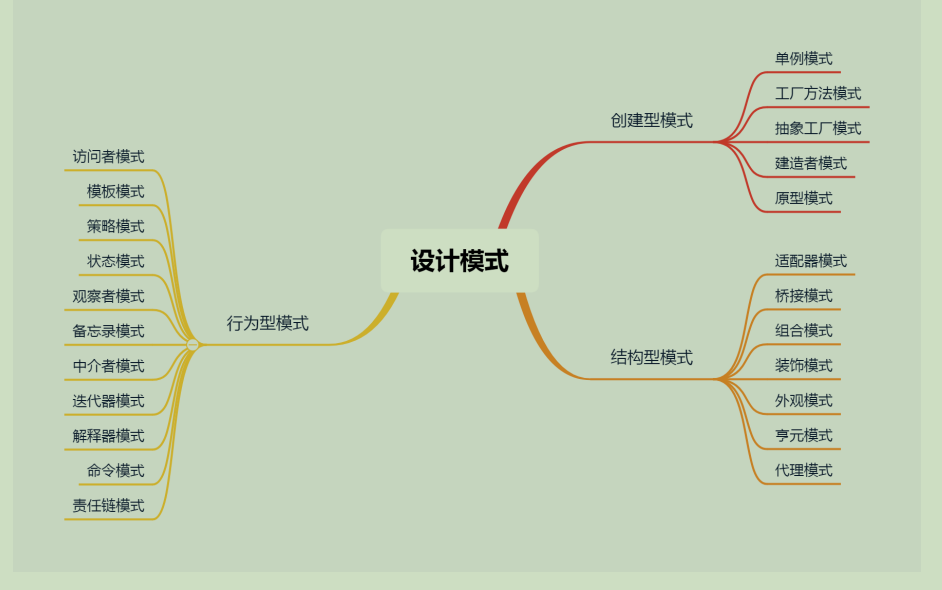
设计模式的分类

  • 创建型:在创建对象的同时隐藏创建逻辑,不适用new 直接实例化对象。 主要有 工厂/抽象工厂/单例/创造者/原型模式
  • 结构型:通过类和接口间的继承和引用实现创建负责结构的对象。包括适配器/桥接模式/过滤器/组合/装饰器/外观/享元/代理模式
  • 行为型:通过类之间不同通信方式实现不同行为,包括责任链/命名/解释器/迭代器/终结者/备忘录/观察者/状态/策略/模板/访问者模式

工厂模式

简单工厂

由一个工厂对象来创建实例,客户但不需要关注创建逻辑,只需要传递工厂参数。

工厂方法模式

工厂方法模式将具体产品的任务分发给具体的产品工厂,也就是一个抽象工厂,定义生产接口但是不负责具体的产品。

抽象工厂

简单和方法只是针对一类产品。
抽象工厂通过在AbstactFactory中增减创建产品的接口,然后由子类工厂去实现新增产品的创建。

单例模式

单例模式是创建型模式,任何情况下只存在一个实例,构造方法必须是私有,由自己创建一个静态变量存储实例,对外提供一个静态公有方法获取实例。
优点是只能有一个实例,减少了开销。

常见的写法

饿汉式

类⼀加载就创建对象

优点:线程安全,没有加锁,执⾏效率较⾼
缺点:不是懒加载,类加载时就初始化,浪费内存空间

public class Singleton {
 // 1、私有化构造⽅法
 private Singleton(){}
 // 2、定义⼀个静态变量指向⾃⼰类型
 private final static Singleton instance = new
Singleton();
 // 3、对外提供⼀个公共的⽅法获取实例
 public static Singleton getInstance() {
	 return instance;
 }
}
懒汉式

单线程模式下没问题,多线程无法保证单例
优点是:懒加载
缺点是:线程安全

public class Singleton {
	 // 1、私有化构造⽅法
	 private Singleton(){ }
	 // 2、定义⼀个静态变量指向⾃⼰类型
	 private static Singleton instance;
	 // 3、对外提供⼀个公共的⽅法获取实例
	 public static Singleton getInstance() {
		 // 判断为 null 的时候再创建对象
		 if (instance == null) {
			 instance = new Singleton();
		 }
		 return instance;
	 }
}

线程安全的懒汉式

使用synchronized关键字枷锁保证线程安全。可以加在方法上面,也可以添加在代码块上面。

public class Singleton {
	 // 1、私有化构造⽅法
	 private Singleton(){ }
	 // 2、定义⼀个静态变量指向⾃⼰类型
	 private static Singleton instance;
	 // 3、对外提供⼀个公共的⽅法获取实例
	 public synchronized static Singleton getInstance() {
		 if (instance == null) {
		 instance = new Singleton();
		 }
		 return instance;
	 }
 }

适配器模式

适配器模式将一个类的接口转化为用户期望的另一个接口,让原本两个不兼容的接口能够无缝完成对接。

优点:

  1. 提⾼了类的复⽤;
  2. 组合若⼲关联对象形成对外提供统⼀服务的接⼝;
  3. 扩展性、灵活性好。
    缺点:
  4. 过多使⽤适配模式容易造成代码功能和逻辑意义的混淆。
  5. 部分语⾔对继承的限制,可能⾄多只能适配⼀个适配者类,⽽且⽬标类必须是抽象类

类适配器

通过类继承,继承Target接口,继承Adaptee的实现

对象适配器

通过类对象组合实现适配

代理模式

本质是一个中间件,主要目的是解耦服务的提供者和使用者,使用者通过代理间接的访问服务提供者。
是一种结构性模式

动态代理和静态代理的区别

动态代理
动态代理是在运行时创建代理对象的机制。代理对象可以在不修改原始对象代码的情况下,拦截对目标对象的方法调用,并在调用前后添加额外的逻辑。Java 中的动态代理主要有两种实现方式:
静态代理
静态代理是在编译时创建代理类的机制。代理类在编译时就已经存在,并且实现了与目标对象相同的接口。静态代理通过在代理类中调用目标对象的方法来实现对目标对象的代理。

  1. 动态代理不需要实现接口可以直接代理实现类,并且可以不许哟啊针对每个目标类都创建一个代理类。静态代理中接口一旦要新增方法,目标对象和代理对象都需要进行修改。
  2. JVM层面:静态代理在编译时就将、接口、实现类、代理类这些都变成一个个实际的class文件。 动态代理是在运行时动态生成类字节码,并且加载到JVM中。

观察者模式

观察者模式是一种对象行为模式,住哟啊处理对象之间的一对多关系。当一个对象状态发生变化时,所有该对象的关注着都能收到状态变化通知进行响应的处理

优点:

  1. 被观察者和观察者之间是抽象耦合的;
  2. 耦合度较低,两者之间的关联仅仅在于消息的通知
  3. 被观察者⽆需关⼼他的观察者;
  4. ⽀持⼴播通信;

缺点:

  1. 观察者只知道被观察对象发⽣了变化,但不知变化的过程和缘由;
  2. 观察者同时也可能是被观察者,消息传递的链路可能会过⻓,完成所有通知花费时间较多;
  3. 如果观察者和被观察者之间产⽣循环依赖,或者消息传递链路形成闭环,会导致⽆限循环;

你的项⽬是怎么⽤的观察者模式?

在⽀付场景下,⽤户购买⼀件商品,当⽀付成功之后三⽅会回调⾃身,在这个时候系统可能会有很多需要执⾏的逻辑(如:更新订单状态,发送邮
件通知,赠送礼品…),这些逻辑之间并没有强耦合,因此天然适合使⽤观察者模式去实现这些功能,当有更多的操作时,只需要添加新的观察者就能实现,完美实现了对修改关闭,对扩展开放的开闭原则。

修饰器模式

修饰器模式住主要是对现有的类对象进行包裹和封装,以期在不改变类对象及其类定义的情况下为对象添加额外功能。是一种对象接口模式。

讲讲装饰器模式的应⽤场景

如果你希望在⽆需修改代码的情况下即可使⽤对象, 且希望在运⾏时为对象新增额外的⾏为, 可以使⽤装饰模式。

装饰能将业务逻辑组织为层次结构, 你可为各层创建⼀个装饰, 在运⾏时
将各种不同逻辑组合成对象。 由于这些对象都遵循通⽤接⼝, 客户端代码能以相同的⽅式使⽤这些对象。

如果⽤继承来扩展对象⾏为的⽅案难以实现或者根本不可⾏, 你可以使⽤该模式。

许多编程语⾔使⽤ final 最终关键字来限制对某个类的进⼀步扩展。 复⽤最终类已有⾏为的唯⼀⽅法是使⽤装饰模式: ⽤封装器对其进⾏封装。

责任链模式

一个请求沿着责任链进行传递,直到链上有某个处理者处理它位为止。

讲讲责任链模式的应⽤场景

当程序需要使⽤不同⽅式处理不同种类请求, ⽽且请求类型和顺序预

先未知时, 可以使⽤责任链模式。该模式能将多个处理者连接成⼀条

链。 接收到请求后, 它会 “询问” 每个处理者是否能够对其进⾏处理。

这样所有处理者都有机会来处理请求。

当必须按顺序执⾏多个处理者时, 可以使⽤该模式。 ⽆论你以何种顺

序将处理者连接成⼀条链, 所有请求都会严格按照顺序通过链上的处

理者

策略模式

对象行为模式,针对一组算法将每一个算法封装到具有共同解耦的独立的类中,从而是他们能够相互替换。

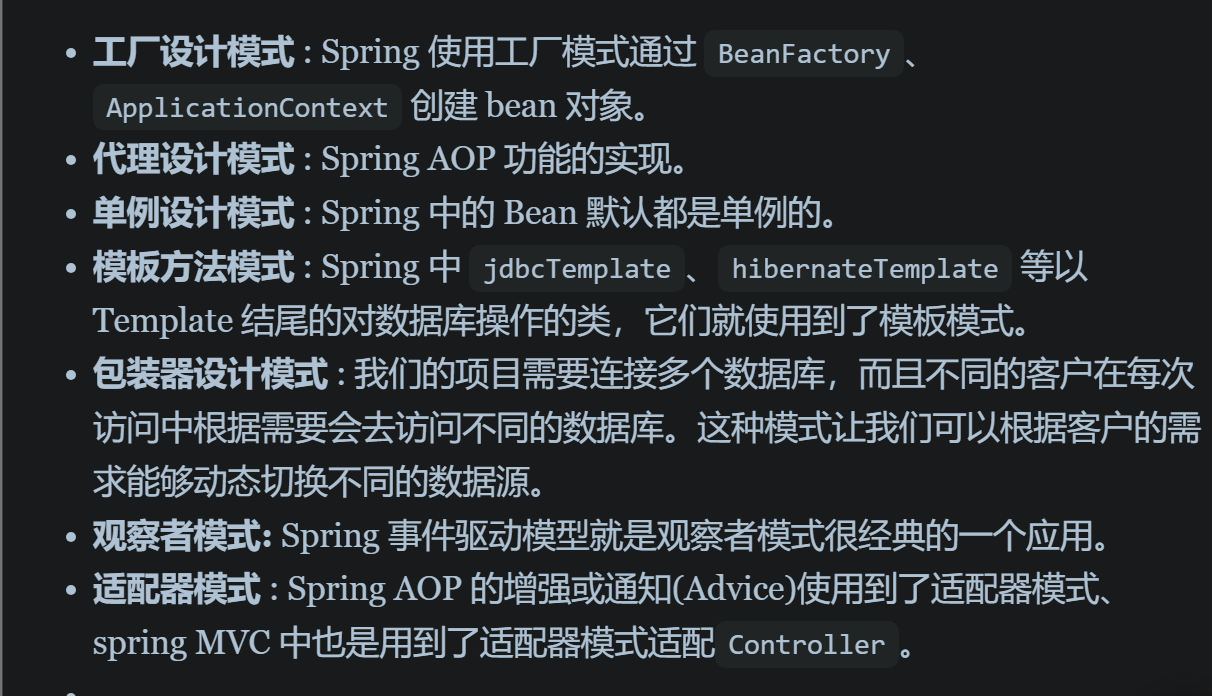
Spring 使⽤了哪些设计模式?

Spring 框架中⽤到了哪些设计模式?

  • ⼯⼚设计模式 : Spring 使⽤⼯⼚模式通过BeanFactory 、 ApplicationContext 创建 bean 对象。
  • 代理设计模式 : Spring AOP 功能的实现。
  • 单例设计模式 : Spring 中的 Bean 默认都是单例的。
  • 模板⽅法模式 : Spring 中 jdbcTemplate 、 hibernateTemplate 等以Template 结尾的对数据库操作的类,它们就使⽤到了模板模式。
  • 包装器设计模式 : 我们的项⽬需要连接多个数据库,⽽且不同的客户在每次访问中根据需要会去访问不同的数据库。这种模式让我们可以根据客户的需求能够动态切换不同的数据源。
  • 观察者模式: Spring 事件驱动模型就是观察者模式很经典的⼀个应⽤。
  • 适配器模式 :Spring AOP 的增强或通知(Advice)使⽤到了适配器模式、spring MVC 中也是⽤到了适配器模式适配 Controller 。

软件工程相关

软件开发模型

瀑布模型(Waterfall Model)、快速原型模型(Rapid Prototype Model)、V 模型(V-model)、W 模型(W-model)、敏捷开发模型等

敏捷开发

敏捷开发 是一种以人为核心、迭代、循序渐进的开发方法。在敏捷开发中,软件项目的构建被切分成多个子项目,各个子项目的成果都经过测试,具备集成和可运行的特征。换言之,就是把一个大项目分为多个相互联系,但也可独立运行的小项目,并分别完成,在此过程中软件一直处于可使用状态。

软件开发的基本策略

软件复用

构建新软件不需要从头开始,可以复用已有的轮子

分而治之

逐步演进

不断进行迭代式增量开发
MVP(Minimum Viable Product 最小可行产品)

优化折中

不需要完全优化,用有效的投入内以最有效的方式提高现有软件的质量

代码规范

命名规范

  • 类名需要使用大驼峰命名法
  • 方法名、参数名、成员变量、局部变量需要使用小驼峰命名法(lowerCamelCase
  • 测试方法名、常量、枚举名称需要使用蛇形命名法(snake_case) (各个单词之间通过下划线“_”连接,比如should_get_200_status_code_when_request_is_valid、CLIENT_CONNECT_SERVER_FAILURE)
  • 项目文件夹名称使用串式命名法,在串式命名法中,各个单词之间通过连接符“-”连接,比如dubbo-registry。
  • 抽象类命名使用 Abstract
  • 异常类命名使用 Exception 结尾。
  • 测试类命名以它要测试的类的名称开始,以 Test 结尾。

面试常问

注解

  • @Nullable 注解的主要作用是为开发者和静态分析工具提供信息,指示某个字段、方法返回值或参数可以为 null。具体来说,它会: 帮助静态分析工具:静态分析工具可以利用 @Nullable 注解来检查代码中是否正确处理了可能为 null 的情况,并在发现潜在问题时发出警告。增强代码可读性:开发者可以通过查看注解来了解哪些变量或返回值可能为 null,从而在使用这些变量时进行适当的空值检查。文档生成:在生成文档时,@Nullable 注解可以帮助其他开发者理解哪些字段、方法返回值或参数可以为 null。它不会直接阻止 NullPointerException 的发生,但能帮助开发者在编写和维护代码时进行适当的空值检查,从而减少空指针异常的发生
  • Bean相关
    • @Autowired和@Resource
      @Autowired默认注入方式是byType,也就是优先根据接口类型去匹配并注入Bean
      @Resource默认是byName注入的,如果不能通过name匹配会变为byType,可以使用只当以下两个属性其中之一来确定,不建议同时指定两个属性
public @interface Resource {
    String name() default "";
    Class<?> type() default Object.class;
}
  • @RestController注解是@Controller和@ResponseBody,会将函数的返回值直接填入HTTP响应体中,是REST风格的控制器
  • @Scope(““)生命作用域:
    • singleton单例作用域,默认全是单例
    • prototype 每次请求都创建一个新的实例
    • request 每次HTTP请求都会创建一个bean,在当前HTTP request有效
    • session 在当前的HTTP session中有效
  • @SpringBootApplication 是@Configuration、@EnableAutoConfiguration、@ComponentScan 注解的集合。
    • @EnableAutoConfiguration 启动自动装配
    • @ComponentScan:扫描注解标记的组件,默认送奥妙该类所在的包下的所有的类
    • @Configuration 允许在 Spring 上下文中注册额外的 bean 或导入其他配置类
  • 读取配置信息并且与bean绑定
    • @Value("${property}") 读取比较简单的配置信息
    • @ConfigurationProperties读取配置信息并与 bean 绑定。
      @Component
      @ConfigurationProperties(prefix = "library")
      class LibraryProperties {
          @NotEmpty
          private String location;
          private List<Book> books;
      
          @Setter
          @Getter
          @ToString
          static class Book {
              String name;
              String description;
          }
        省略getter/setter
        ......
      }
      

Bean

  • Bean的作用域
    1. singleton单例:Spring中的bean默认都是单例的
    2. prototype:每次获取都会创建一个新的Bean,也就是连续两次获取Bean都会是不同的Bean实例
    3. request:每一次HTTP请求都会产生一个新的bean,bean在当前HTTP request内生效
    4. sesson:在HTTP的session中有效,session是多个HTTP之间使用的连续会话
    5. application/global-session (仅 Web 应用可用):每个 Web 应用在启动时创建一个 Bean(应用 Bean),该 bean 仅在当前应用启动时间内有效。
    6. websocket:每一次WebSocket都会产生一个新的bean
      配置方式:
      @Bean
      @Scope(value = ConfigurableBeanFactory.SCOPE_PROTOTYPE)
      public Person personPrototype() {
          return new Person();
      }
      
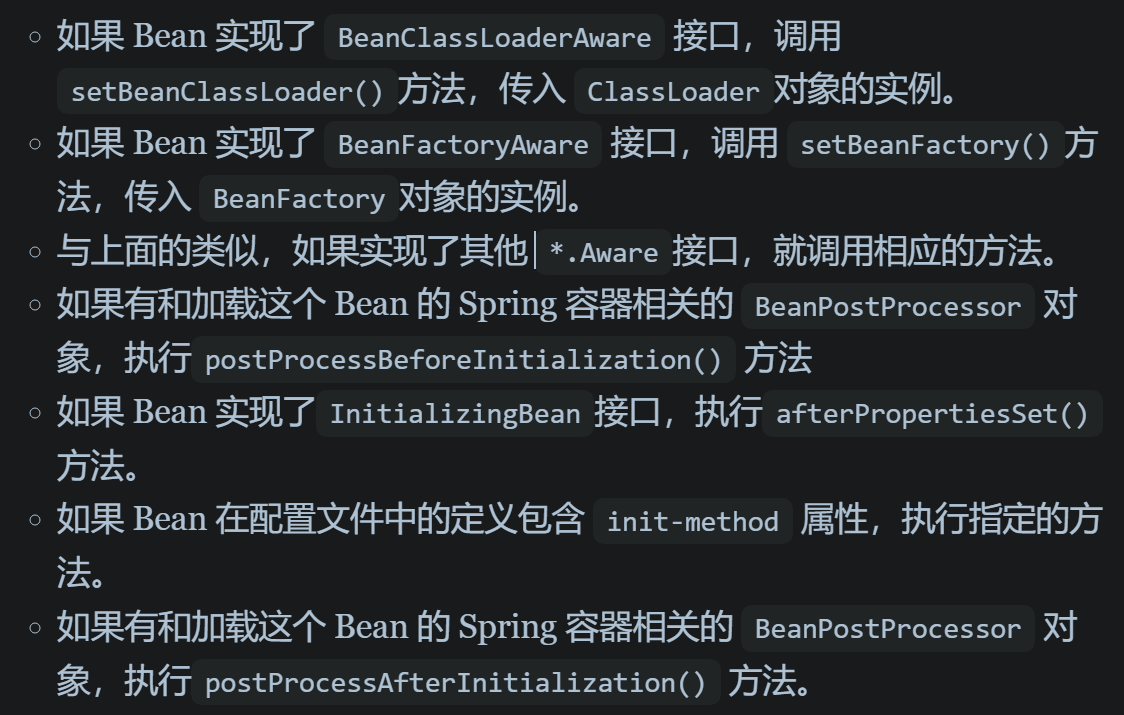
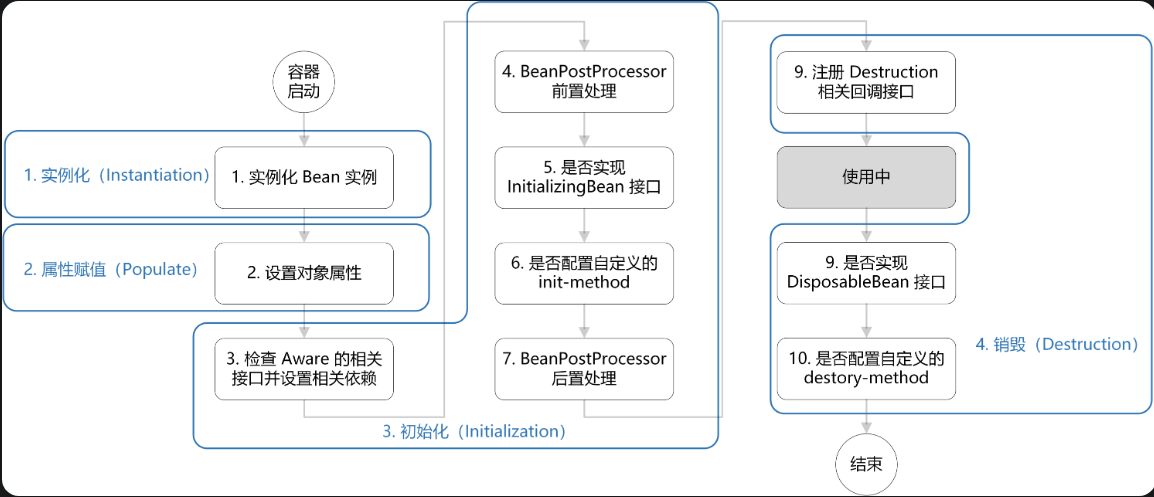
  • Bean的生命周期
    1. 创建Bean的实例:Bean容器会先找到Bean的定义,然后通过Java反射API来创建Bean的实例
    2. Bean属性赋值/填充:为Bean设置相关属性和依赖,例如填入@Autowired等注解注入的对象,setter方法和构造函数
    3. Bean初始化:Bean的初始化
    4. 销毁Bean:把Bean的销毁方法记录下来,将爱需要销毁Bean或者销毁容器时,调用这些方法去释放Bean所持有的资源
      • 如果 Bean 实现了 DisposableBean 接口,执行 destroy() 方法。
      • 如果 Bean 在配置文件中的定义包含 destroy-method 属性,执行指定的 Bean 销毁方法。或者,也可以直接通过@PreDestroy 注解标记 Bean 销毁之前执行的方法。
|475


AOP

常见实现

Spring AOP实现方式有动态代理、字节码等操作方式

常见术语:
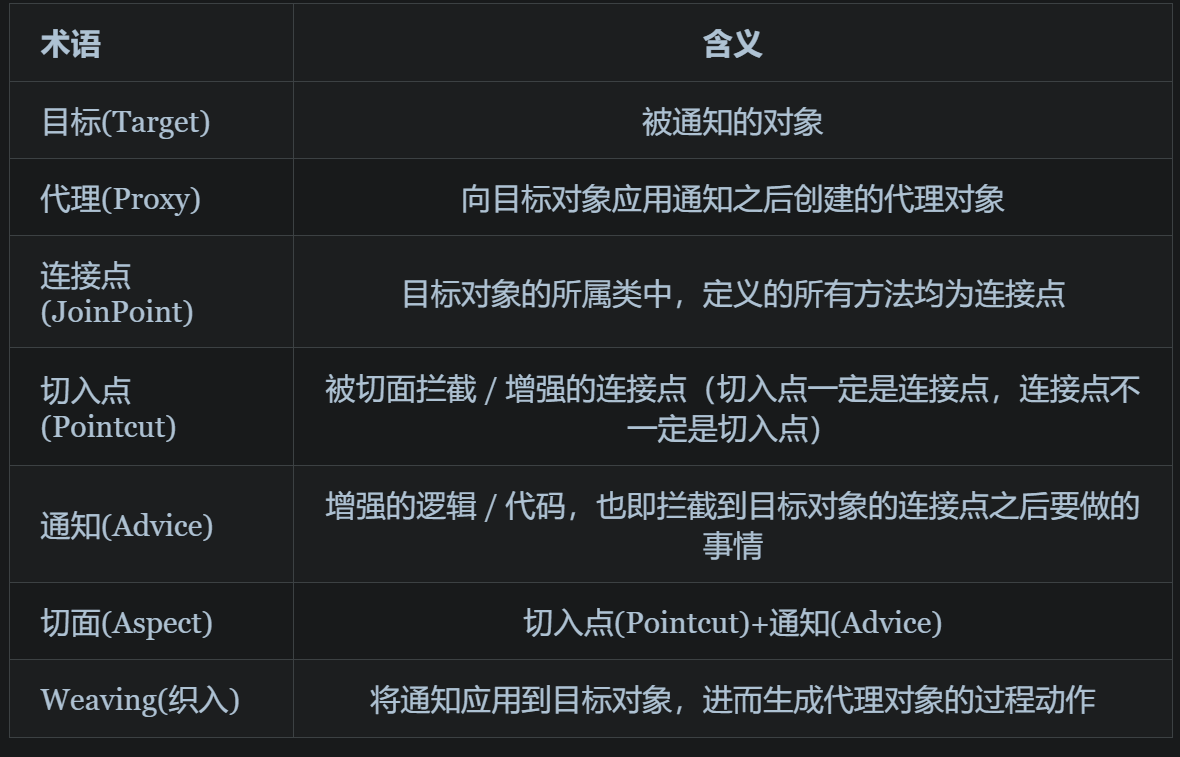
AspectJ定义的通知类型

  • Before 前置通知:在目标方法调用之前,所以获得不到目标方法的具体东西
  • After 后置通知:目标方法调用之后,类似于finally,无论方法是否成功都会调用
  • AfterReturing:目标方法调用之后,返回结果之后触发,只有方法完成成功会调用
  • AfterThrowing:异常通知,出现异常时触发,类似catch
  • Around环绕通知:可以拿到目标对象
    对于多个切面的执行顺序可以通过@Order(数字) 来指定

Spring MVC

MVC 是模型(Model)、视图(View)、控制器(Controller)的简写,其核心思想是通过将业务逻辑、数据、显示分离来组织代码。
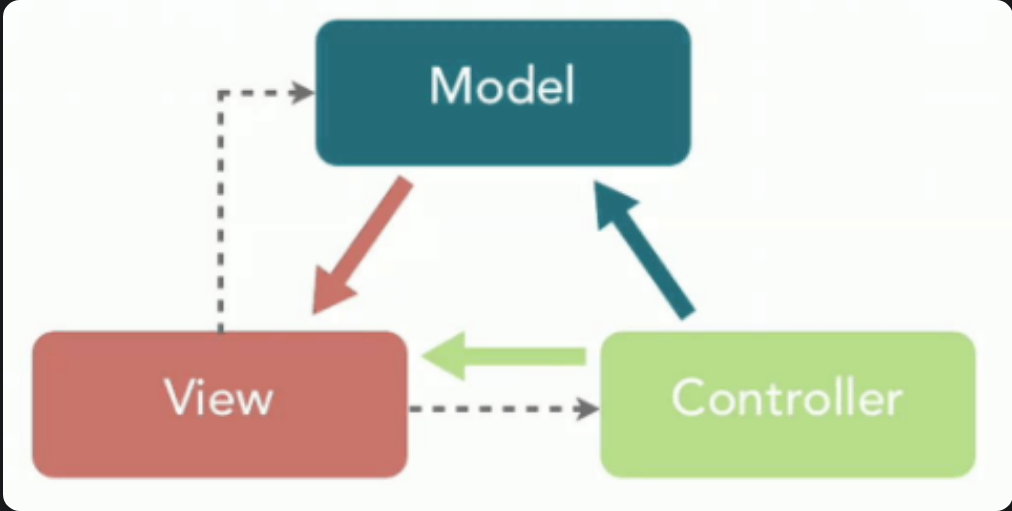
核心组件:

  • **DispatcherServlet**“:核心中央处理器,用汉语接受请求、分发请求,给予客户端响应
  • HandlerMapping:处理器映射器,根据URL去匹配查找能处理的Handler,并将涉及的拦截器和Handler一起封装
  • HandlerAdapter:处理器适配器,根据HandlerMapping找到的Handler,设配置型对应的Handler
  • Handler:请求处理器
  • ViewResolver:视图解析器,根据Handler返回的逻辑视图/试图,解析并渲染真正的试图,传递给DispatcherServlet响应客户端。
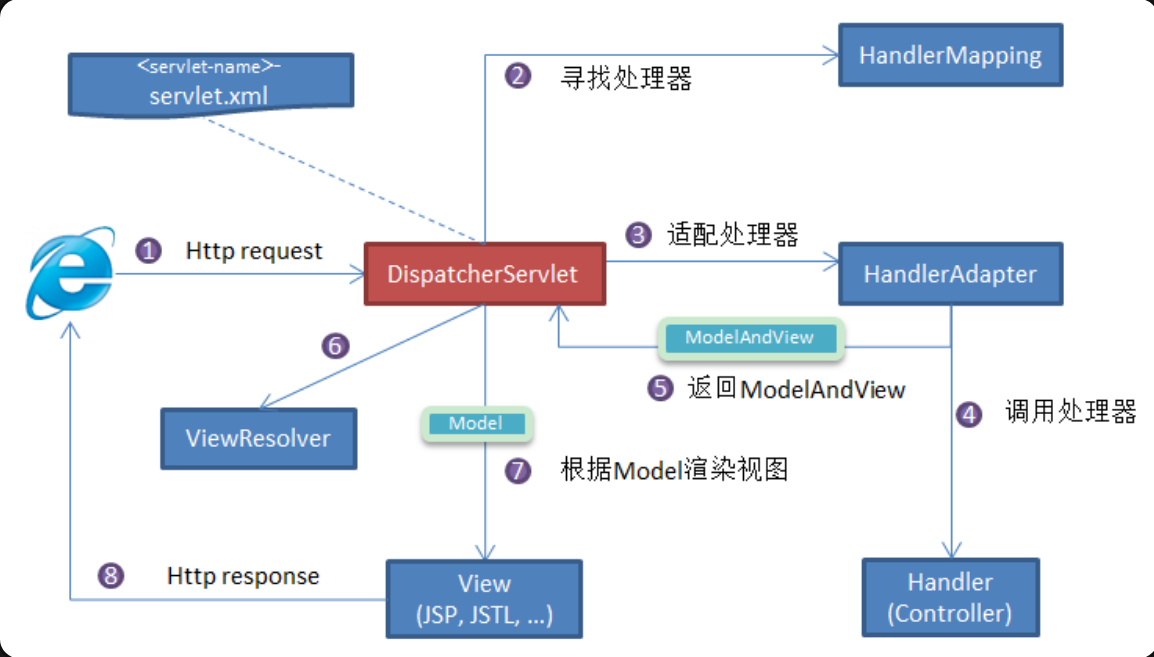
    流程说明(重要):
  1. 客户端(浏览器)发送请求, DispatcherServlet拦截请求。
  2. DispatcherServlet 根据请求信息调用 HandlerMapping 。HandlerMapping 根据 URL 去匹配查找能处理的 Handler(也就是我们平常说的 Controller 控制器) ,并会将请求涉及到的拦截器和 Handler 一起封装。
  3. DispatcherServlet 调用 HandlerAdapter适配器执行 Handler 。
  4. Handler 完成对用户请求的处理后,会返回一个 ModelAndView 对象给DispatcherServlet,ModelAndView 顾名思义,包含了数据模型以及相应的视图的信息。Model 是返回的数据对象,View 是个逻辑上的 View。
  5. ViewResolver 会根据逻辑 View 查找实际的 View。
  6. DispaterServlet 把返回的 Model 传给 View(视图渲染)。
  7. 把 View 返回给请求者(浏览器)

Spring使用的设计模式:

Spring事务

ACID AID是手段,最终目的是保证C

相关接口
  • **PlatformTransactionManager**:(平台)事务管理器,Spring 事务策略的核心。

  • **TransactionDefinition**:事务定义信息(事务隔离级别、传播行为、超时、只读、回滚规则)。

  • **TransactionStatus**:事务运行状态。

    • 编程式事务 (推荐在分布式系统中使用)通过手动使用TransactionTemplate或者TranctionManager手动管理事务,事务范围过大会出现事务未提交导致超时,因此事务要比锁的颗粒度更小
public class UserService {

    private TransactionTemplate transactionTemplate;

    public UserService(TransactionTemplate transactionTemplate) {
        this.transactionTemplate = transactionTemplate;
    }

    public User createUser(final String username) {
        return transactionTemplate.execute(new TransactionCallback<User>() {
            @Override
            public User doInTransaction(TransactionStatus status) {
                try {
                    // 这里是你的业务代码
                    // 如果在这里抛出了异常,TransactionTemplate会捕获这个异常并回滚事务
                    // 如果这里没有抛出异常,TransactionTemplate会提交事务
                } catch (Exception e) {
                    status.setRollbackOnly();
                    throw e;
                }
            }
        });
    }
}
  • 声明式事务:通过使用@Tranctional全注解
    事务
    Spring事务中有哪几种传播行为
  1. **TransactionDefinition.PROPAGATION_REQUIRED**,默认,如果当前存在事务,就加入该事务,否则创建一个新的 事务
  2. TransactionDefinition.PROPAGATION_REQUIRES_NEW 创建一个新事务,当前存在事务就把
  3. TransactionDefinition.PROPAGATION_NESTED 没有事务就创建一个事务左伟当前事务的嵌套事务,存在事务就和 1 相同
  4. TransactionDefinition.PROPAGATION_MANDATORY 如果存在事务就加入该事务,不存在事务就报错
  • TransactionDefinition.PROPAGATION_SUPPORTS: 如果当前存在事务,则加入该事务;如果当前没有事务,则以非事务的方式继续运行。
  • TransactionDefinition.PROPAGATION_NOT_SUPPORTED: 以非事务方式运行,如果当前存在事务,则把当前事务挂起。
  • TransactionDefinition.PROPAGATION_NEVER: 以非事务方式运行,如果当前存在事务,则抛出异常。

Spring事务隔离级别

  1. **TransactionDefinition.ISOLATION_DEFAULT**:使用后端数据库的默认隔离等级,MySQL采用可重复读,Oracle默认采用读已提交
  2. **TransactionDefinition.ISOLATION_READ_UNCOMMITTED**:最低的隔离等级,允许读已提交,可能会导致脏读,幻读和不可重复读
  3. **TransactionDefinition.ISOLATION_READ_COMMITTED**:允许读并发事务已提交的事务,可以阻止脏读,但是幻读和不可重复仍有可能发生。
  4. **TransactionDefinition.ISOLATION_REPEATABLE_READ**:对同意字段多次读都是相同的,可以组织脏读和不可重复读,但是幻读仍然会发生
  5. **TransactionDefinition.ISOLATION_SERIALIZABLE**: 序列化,最高的隔离级别,影响程序性能

Transactional(rollbackFor = Exception.class)
默认回滚是只有遇到RuntimeException运行时异常或者Error才进行回滚,而不会回滚,Checked Exception(Checked Exception是那些在编译时期就需要被处理的异常),
@Transactional(rollbackFor = Exception.class,rollbackFor = Exception.class)
public void someMethod() {
// some business logic
}

Spirng Data JPA (Java Persistence API)

是Java平台上的一个规范,用于将对象映射到关系数据库

如何使用JPA在数据库中非持久化一个字段

非持久化:也就是不被数据库存储
可以使用注解的方式:

@Entity(name = "student")
public class Student {
    @Id
    @GeneratedValue(strategy= GenerationType.AUTO) // 自增
    @Column(name = "id")
    private Long id;
    @Column(name = "name")
    private String name;
    @Column(name = "age")
    private Integer age;
    
    @Transient // 不映射到数据库
    private String secrect;
    
}

JPA审计功能

审计功能主要是帮助我们记录数据库操作的具体行为比如某条记录是谁创建的、什么时间创建的、最后修改人是谁、最后修改时间是什么时候。
示例:

@Data
@AllArgsConstructor
@NoArgsConstructor
@MappedSuperclass
@EntityListeners(value = AuditingEntityListener.class)
public abstract class AbstractAuditBase {

    @CreatedDate //该字段为创建时间字段,在insert时会插入
    @Column(updatable = false)
    @JsonIgnore //不进行序列化
    private Instant createdAt;

    @LastModifiedDate //最后一次更新时间
    @JsonIgnore
    private Instant updatedAt;

    @CreatedBy //标记创建人
    @Column(updatable = false) //不允许更新
    @JsonIgnore
    private String createdBy;

    @LastModifiedBy //最后一次更新人
    @JsonIgnore
    private String updatedBy;
}

Spring Security

控制访问权限的方法:

  • permitAll():无条件允许任何形式访问,不管你登录还是没有登录。
  • anonymous():允许匿名访问,也就是没有登录才可以访问。
  • denyAll():无条件决绝任何形式的访问。
  • authenticated():只允许已认证的用户访问。
  • fullyAuthenticated():只允许已经登录或者通过 remember-me 登录的用户访问。
  • hasRole(String) : 只允许指定的角色访问。
  • hasAnyRole(String) : 指定一个或者多个角色,满足其一的用户即可访问。
  • hasAuthority(String):只允许具有指定权限的用户访问
  • hasAnyAuthority(String):指定一个或者多个权限,满足其一的用户即可访问。
  • hasIpAddress(String) : 只允许指定 ip 的用户访问。

参数校验

Hibernate Validator

使用时建议使用**javax.validation.constraints**中的注解
常见的注解:

  • @NotEmpty 被注释的字符串的不能为 null 也不能为空
  • @NotBlank 被注释的字符串非 null,并且必须包含一个非空白字符
  • @Null 被注释的元素必须为 null
  • @NotNull 被注释的元素必须不为 null
  • @AssertTrue 被注释的元素必须为 true
  • @AssertFalse 被注释的元素必须为 false
  • @Pattern(regex=,flag=)被注释的元素必须符合指定的正则表达式
  • @Email 被注释的元素必须是 Email 格式。
  • @Min(value)被注释的元素必须是一个数字,其值必须大于等于指定的最小值
  • @Max(value)被注释的元素必须是一个数字,其值必须小于等于指定的最大值
  • @DecimalMin(value)被注释的元素必须是一个数字,其值必须大于等于指定的最小值
  • @DecimalMax(value) 被注释的元素必须是一个数字,其值必须小于等于指定的最大值
  • @Size(max=, min=)被注释的元素的大小必须在指定的范围内
  • @Digits(integer, fraction)被注释的元素必须是一个数字,其值必须在可接受的范围内
  • @Past被注释的元素必须是一个过去的日期
  • @Future 被注释的元素必须是一个将来的日期
  • @Positive和@PositiveOrZero验证数字必须为正数/包括0,同理 @Negative为负数

示例1:

@Data
@AllArgsConstructor
@NoArgsConstructor
public class Person {

    @NotNull(message = "classId 不能为空")
    private String classId;

    @Size(max = 33)
    @NotNull(message = "name 不能为空")
    private String name;

    @Pattern(regexp = "((^Man$|^Woman$|^UGM$))", message = "sex 值不在可选范围")
    @NotNull(message = "sex 不能为空")
    private String sex;

    @Email(message = "email 格式不正确")
    @NotNull(message = "email 不能为空")
    private String email;

}
//在需要校验的参数上使用@Valid,如果验证失败,会抛出我们在需要验证的参数上加上了`@Valid`注解,如果验证失败,它将抛出MethodArgumentNotValidException
@RestController
@RequestMapping("/api")
public class PersonController {

    @PostMapping("/person")
    public ResponseEntity<Person> getPerson(@RequestBody @Valid Person person) {
        return ResponseEntity.ok().body(person);
    }
}

示例2:验证请求参数,要求在类上加@Validated注解

@RestController
@RequestMapping("/api")
@Validated
public class PersonController {

    @GetMapping("/person/{id}")
    public ResponseEntity<Integer> getPersonByID(@Valid @PathVariable("id") @Max(value = 5,message = "超过 id 的范围了") Integer id) {
        return ResponseEntity.ok().body(id);
    }
}

使用@Validated来指定不同的组别条件下使用不同的校验方法

  1. 定义组别接口,为空即可
    public class User {
    
        @NotBlank(groups = CreateGroup.class) // 创建时需要校验
        private String username;
    
        @Size(min = 6, max = 14, groups = UpdateGroup.class) // 更新时需要校验
        private String password;
    
        // getters and setters
    }
  2. 定义类的校验规则,根据组别来写
    public class User {
    
        @NotBlank(groups = CreateGroup.class) // 创建时需要校验
        private String username;
    
        @Size(min = 6, max = 14, groups = UpdateGroup.class) // 更新时需要校验
        private String password;
    
        // getters and setters
    }
  3. 不同的方法上的传参使用不同的组别来进行校验
    
    public class User {
    
        @NotBlank(groups = CreateGroup.class) // 创建时需要校验
        private String username;
    
        @Size(min = 6, max = 14, groups = UpdateGroup.class) // 更新时需要校验
        private String password;
    
        // getters and setters
    }

全局处理Controller层异常

@ControllerAdvice
@ResponseBody
public class GlobalExceptionHandler {

    /**
     * 请求参数异常处理
     */
    @ExceptionHandler(MethodArgumentNotValidException.class)
    public ResponseEntity<?> handleMethodArgumentNotValidException(MethodArgumentNotValidException ex, HttpServletRequest request) {
       ......
    }
}

JPA

  • @Entity声明一个类对应一个数据库实体。
  • @Table 设置表名
  • @Id声明主键
  • GeneratedValue 主键填充策略
    public enum GenerationType {
    
        /**
         * 使用一个特定的数据库表格来保存主键
         * 持久化引擎通过关系数据库的一张特定的表格来生成主键,
         */
        TABLE,
    
        /**
         *在某些数据库中,不支持主键自增长,比如Oracle、PostgreSQL其提供了一种叫做"序列(sequence)"的机制生成主键
         */
        SEQUENCE,
    
        /**
         * 主键自增长
         */
        IDENTITY,
    
        /**
         *把主键生成策略交给持久化引擎(persistence engine),
         *持久化引擎会根据数据库在以上三种主键生成 策略中选择其中一种
         */
        AUTO //默认
    }
    
  • @Column 设置字段
    //设置字段类型,并且增加一个默认值
    @Column(columnDefinition = "tinyint(1) default 1")
    private Boolean enabled;
    
  • @Transient 声明不需要持久化的字段,也就是不需要保存进数据库
  • 声明大字段:
    • TEXT:用于存储大量的非二进制字符串(字符数据)。它可以存储最多 2^16 - 1 字符。
    • BLOB:用于存储大量的二进制数据。它可以存储最多 2^16 - 1 字节的数据。
    • MEDIUMTEXT 和 MEDIUMBLOB:这两种类型可以存储更多的数据,最多 2^24 - 1 字符或字节。
    • LONGTEXT 和 LONGBLOB:这两种类型可以存储最多 2^32 - 1 字符或字节的数据,适用于非常大的数据。
      @Lob
      //指定 Lob 类型数据的获取策略, FetchType.EAGER 表示非延迟加载,而 FetchType.LAZY 表示延迟加载 ;
      @Basic(fetch = FetchType.EAGER)
      //columnDefinition 属性指定数据表对应的 Lob 字段类型
      @Column(name = "content", columnDefinition = "LONGTEXT NOT NULL")
      private String content;
      
  • 创建枚举字段:自己创建枚举类,然后在枚举字段上加上@Enumerated注解即可
    public enum Gender {
        MALE("男性"),
        FEMALE("女性");
    
        private String value;
        Gender(String str){
            value=str;
        }
    }
    
    @Entity
    @Table(name = "role")
    public class Role {
        @Id
        @GeneratedValue(strategy = GenerationType.IDENTITY)
        private Long id;
        private String name;
        private String description;
        @Enumerated(EnumType.STRING)
        private Gender gender;
        省略getter/setter......
    }
    
  • 审计: 待补
  • 删除/修改数据:
    @Repository
    public interface UserRepository extends JpaRepository<User, Integer> {
    
        @Modifying
        @Transactional(rollbackFor = Exception.class)
        void deleteByUserName(String userName);
    }
    
  • 关联关系:
    • @OneToOne 声明一对一关系
    • @OneToMany 声明一对多关系
    • @ManyToOne 声明多对一关系
    • @ManyToMany 声明多对多关系

JSON处理

  • @JsonIgnoreProperties 用于类上
  • JsonIgnore 用于属性上
    进行序列化时,会忽略标记的值,示例:
    {
        "from": "user1",
        "to": "user2",
        "content": {"text": "Hello"},
        "image": "image_url",
        "readed": 1,
        "date": "2023-01-01 12:00:00"
    }
    //在类上的image字段上标记 @Ignore
    那么序列化之后的结果是
    {
        "from": "user1",
        "to": "user2",
        "content": {"text": "Hello"},
        "readed": 1,
        "date": "2023-01-01 12:00:00"
    }
  • JSON扁平化:@JsonUnwrapped.

测试相关

  • @ActiveProfiles(“prod”) 作用于类上,用于生命生效的Spring配置文件
    @SpringBootTest(webEnvironment = RANDOM_PORT)
    @ActiveProfiles("test")
    @Slf4j
    public abstract class TestBase {
      ......
    }
  • @Test 声明为一个测试方法,@Transactional用于回滚测试数据, 注意: @Transactional无法回滚MongoDB等NoSQL数据库,MongoDB支持副本集回滚事务

IOC

控制反转,将new 交由Spring框架管理,Bean的生命周期都由Spring调用
优点:

  1. 资源变得容易管理:
  2. 降低对象之间的耦合和依赖

SpringBoot

@SpringBootConfiguration注解

里面包含三个注解

@SpringBootConfiguration // 标识这是一个配置类
@EnableAutoConfiguration // 开启自动装配
@ComponentScan( // 配置扫描路径,用来加载使用注解格式自定的Bean
    excludeFilters = {@Filter(
    type = FilterType.CUSTOM,
    classes = {TypeExcludeFilter.class}
), @Filter(
    type = FilterType.CUSTOM,
    classes = {AutoConfigurationExcludeFilter.class}
)}
)

其中@EnableAutoConfiguration注解又包括以下两种注解:

@AutoConfigurationPackage // 指定默认的包规则,也就是主程序类所在的包及其所有子包下的组件扫描到Spring容器中
@Import({AutoConfigurationImportSelector.class}) // 引入AutoConfigurationImportSelector类,通过该类的selectImports方法去读取META-INF/spring.factories文件中配置的组件的全类名,并且按照一定的规则过滤掉不符合要求的组件的全类名,将剩余读取到的哥哥组件中的全类名集合返回给IOC容器,并将这些组件注册为bean

这是@AutoConfigurationPackage注解的内容

@Target({ElementType.TYPE})
@Retention(RetentionPolicy.RUNTIME)
@Documented
@Inherited
@Import({AutoConfigurationPackages.Registrar.class})
public @interface AutoConfigurationPackage {
    String[] basePackages() default {};

    Class<?>[] basePackageClasses() default {};
}

1、利用getAutoConfigurationEntry(annotationMetadata);给容器中批量导入一些组件
2、调用List configurations = getCandidateConfigurations(annotationMetadata, attributes)获取到所有需要导入到容器中的配置类
3、利用工厂加载 Map<String, List> loadSpringFactories(@Nullable ClassLoader classLoader);得到所有的组件
4、从META-INF/spring.factories位置来加载一个文件。默认扫描我们当前系统里面所有META-INF/spring.factories位置的文件,按照条件装配( @ C o n d i t i o n a l ) 最终会按需配置 {按照条件装配(@Conditional)最终会按需配置}按照条件装配(@Conditional)最终会按需配置

SpringBoot自动装配原理

@EnableAutoConfiguration:实现自动装配的核心

先说结论:实际上就是从META-INF/spring.factories文件中获取需要进行自动装配的类,生成响应的Bean对象,然后交给Spring容器管理。这个和手写starter包很类似

Spring源码阅读

推荐文章:xuchengsheng/spring-reading(github.com)

Resource

Resource 是Spring框架中用于简化和统一对底层资源(如文件、classpath 资源、URL 等)的访问的一个核心接口。

基本概念

classpath 是 Java 虚拟机(JVM)和 Java 编译器用来查找类文件和资源文件的路径。它指定了 Java 应用程序在运行时或编译时需要的类和资源的位置。classpath 可以包含目录、JAR 文件或 ZIP 文件。

主要功能

  1. 统一的资源抽象,无论资源来自文件系统、classpath、URL还是其他,Resource提供统一的抽象
  2. 资源描述通过getDescription来获得底层资源提供的描述性信息
  3. 读取能力:Resource提供了getInputStream方法,允许直接读取资源内容而无需关心资源的实际来源。
  4. 存在与可读性:Resource提供了两个方法来确定资源是否存在以及是否可读。
  5. 开放性检查:isOpen()用来检查资源是否标识一个已经打开的流,有助于避免重复读取流资源。
  6. 文件访问:当资源代表一个文件夹中的文件时,可以通过getFile()直接访问该文件
  7. Spring提供了多种Resource的实现

源码:

/**
 * 表示可以提供输入流的资源或对象的接口。
 */
public interface InputStreamSource {

	/**
	 * 返回基础资源内容的 InputStream。
	 * 期望每次调用都会创建一个新的流。
	 * 当我们考虑到像 JavaMail 这样的API时,这个要求尤为重要,因为在创建邮件附件时,JavaMail需要能够多次读取流。对于这样的用例,要求每个 getInputStream() 调用都返回一个新的流。
	 * @return 基础资源的输入流(不能为 null)
	 * @throws java.io.FileNotFoundException 如果基础资源不存在
	 * @throws IOException 如果无法打开内容流
	 */
	InputStream getInputStream() throws IOException;

}

ResourceLoader

Spring 框架中的一个关键接口,它定义了如何获取资源(例如类路径资源、文件系统资源或网页资源)的策略。这个接口是 Spring 资源加载抽象的核心,使得应用程序可以从不同的资源位置以统一的方式加载资源。
用于获取Resource对象的工厂。

主要功能

  1. 统一的资源加载,提供了一个标准化的方法来加载资源,不论资源是存放在类路径、文件系统、网络URL还是其他位置
  2. 资源位置解析:根据提供的资源字符串位置,可以确定资源的类型,并且为其创建响应的Resource实例
  3. 返回Resource实例:getResource(String location)方法,返回一个Resource对象,代表了指定位置的资源。
  4. 与ClassLoader交互:通过getClassLoader()方法返回其关联的ClassLoader
  5. 扩展性:ResourceLoader 是一个接口,这意味着我们可以实现自己的资源加载策略,或者扩展默认的策略以满足特定需求。
  6. 内置实现与整合:Spring 提供了默认的 ResourceLoader 实现,如 DefaultResourceLoader。但更重要的是,org.springframework.context.ApplicationContext 也实现了 ResourceLoader,这意味着 Spring 上下文本身就是一个资源加载器。

源码:

public interface ResourceLoader {
	//默认的classpath路径
    String CLASSPATH_URL_PREFIX = "classpath:";

    Resource getResource(String var1);

    @Nullable
    ClassLoader getClassLoader();
}

默认实现


public class DefaultResourceLoader implements ResourceLoader {
    @Nullable
    private ClassLoader classLoader;
    //自定义的协议
    private final Set<ProtocolResolver> protocolResolvers = new LinkedHashSet(4);
	//缓存
    private final Map<Class<?>, Map<Resource, ?>> resourceCaches = new ConcurrentHashMap(4);

    
/* 
省略构造方法和一些不重要的方法
*/

    public <T> Map<Resource, T> getResourceCache(Class<T> valueType) {
        return (Map)this.resourceCaches.computeIfAbsent(valueType, (key) -> {
            return new ConcurrentHashMap();
        });
    }


// 根据不同的路径参数来返回对应的Resource
    public Resource getResource(String location) {
        Assert.notNull(location, "Location must not be null");
        Iterator var2 = this.getProtocolResolvers().iterator();

        Resource resource;
        do {
            if (!var2.hasNext()) {
                if (location.startsWith("/")) {
                    return this.getResourceByPath(location);
                }

                if (location.startsWith("classpath:")) {
                    return new ClassPathResource(location.substring("classpath:".length()), this.getClassLoader());
                }

                try {
                    URL url = new URL(location);
                    return (Resource)(ResourceUtils.isFileURL(url) ? new FileUrlResource(url) : new UrlResource(url));
                } catch (MalformedURLException var5) {
                    return this.getResourceByPath(location);
                }
            }

            ProtocolResolver protocolResolver = (ProtocolResolver)var2.next();
            resource = protocolResolver.resolve(location, this);
        } while(resource == null);

        return resource;
    }

    protected Resource getResourceByPath(String path) {
        return new ClassPathContextResource(path, this.getClassLoader());
    }

    protected static class ClassPathContextResource extends ClassPathResource implements ContextResource {
        public ClassPathContextResource(String path, @Nullable ClassLoader classLoader) {
            super(path, classLoader);
        }

        public String getPathWithinContext() {
            return this.getPath();
        }

        public Resource createRelative(String relativePath) {
            String pathToUse = StringUtils.applyRelativePath(this.getPath(), relativePath);
            return new ClassPathContextResource(pathToUse, this.getClassLoader());
        }
    }
}

computeIfAbsent 是 Java 8 引入的 Map 接口中的一个默认方法。它用于在 Map 中查找指定键的值,如果该键不存在,则使用提供的映射函数计算该键的值,并将其插入到 Map 中,第二个参数可以传入lambda

ResourcePatternResolver

用于解析资源模式,支持通过模式匹配检索多个资源,支持通过模式匹配检索多个资源。

主要功能

  1. 资源模式解析

    • 通过getResources(String locationPattern)方法,支持使用通配符的资源模式,如classpath*:com/example/**/*.xml,用于检索匹配特定模式的多个资源。
  2. 资源获取

    • 通过getResources(Resource location)方法,根据给定的资源对象,返回匹配的资源数组。这使得可以获取与特定资源相关联的其他资源,例如获取与给定类路径下的一个文件相关的所有资源。
  3. 多种资源位置支持

    • 可以处理不同的资源位置,包括类路径(classpath)、文件系统、URL等。这使得应用程序能够以不同的方式组织和存储资源,而不影响资源的检索和加载。
  4. 灵活的资源加载

    • 结合ResourceLoader的能力,ResourcePatternResolver允许在应用程序中以统一的方式加载各种资源,而无需关心底层资源的存储位置或形式。
  5. 通用资源操作

    • 通过Resource接口,提供了对资源的通用操作,例如获取资源的URL、输入流、文件句柄等。

源码

public interface ResourcePatternResolver extends ResourceLoader {

    /**
     * 类路径匹配所有资源的伪 URL 前缀:"classpath*:"
     * 这与 ResourceLoader 的类路径 URL 前缀不同,它检索给定名称(例如 "/beans.xml")的
     * 所有匹配资源,例如在所有部署的 JAR 文件的根目录中。
     * 详见 org.springframework.core.io.ResourceLoader#CLASSPATH_URL_PREFIX
     */
    String CLASSPATH_ALL_URL_PREFIX = "classpath*:";

    /**
     * 将给定的位置模式解析为 Resource 对象。
     * 应尽可能避免指向相同物理资源的重叠资源条目。结果应具有集合语义。
     * @param locationPattern 要解析的位置模式
     * @return 相应的 Resource 对象数组
     * @throws IOException 如果发生 I/O 错误
     */
    Resource[] getResources(String locationPattern) throws IOException;
}

DocumentLoader

用于加载和解析 XML 文档

主要功能

  1. 加载XML文档
  2. 解析XML文档
  3. 支持验证:通过指定验证模式(如 DTD 或 XML Schema 验证),可以确保文档的结构和内容符合规定的标准。
  4. 处理实体引用
  5. 错误处理

MetadataReader

一些重要概念

内部类在编译后,其文件名格式为 OuterClass$InnerClass.class。

主要功能

  1. 获取类的基本信息
  2. 获取类上的注解信息
  3. 获取方法上的注解信息
  4. 获取类的成员类信息
  5. 获取类的资源信息
  6. 获取类的超类信息

源码

public interface MetadataReaderFactory {
    MetadataReader getMetadataReader(String var1) throws IOException;

    MetadataReader getMetadataReader(Resource var1) throws IOException;
}

SpringMVC

拦截器和过滤器的区别
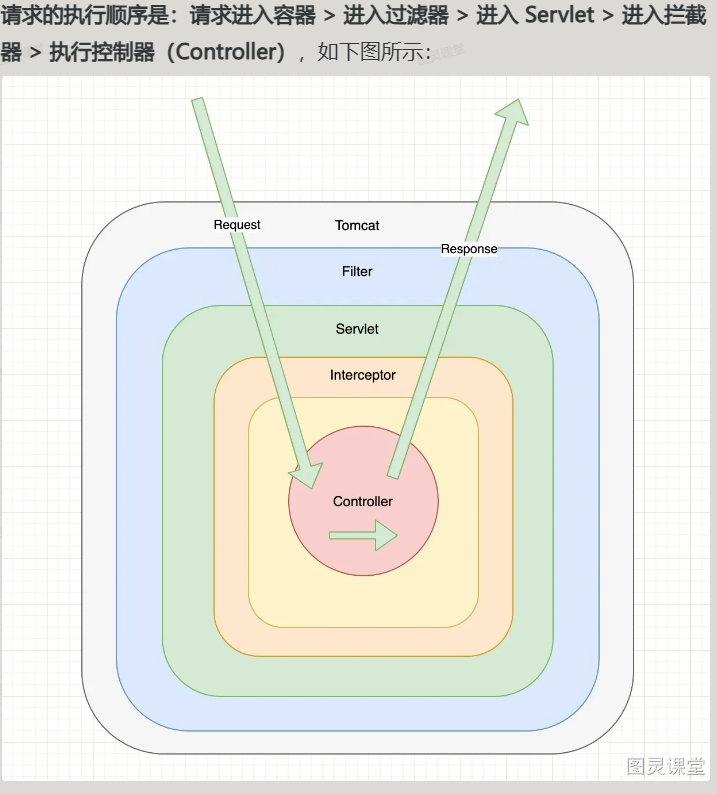
  1. 过滤器来自Servlet,而拦截器属于Spring框架中的
  2. 请求进入容器->过滤器->Servlet->进入拦截器->执行Controller
  3. 过滤器是基于方法回调,doFilter来执行的,而拦截器则是基于动态代理实现的

Docker Compose

编写docker-compose.yml脚本,配合dockerfile和sh脚本进行搭建

  • 示例一:搭建一主二从三哨兵的redis集群 ^220b94
    version: '3' #dockercompose版本
    services: #定义应用的的服务,每个服务运行一个镜像
      redis-master: #服务名称
        image: redis:latest #镜像
        command: redis-server --appendonly yes --requirepass bronya #启动容器时要执行命令
        volumes: #挂载数据卷,不存在的目录会自动创建
          - ./data/master:/data
        ports: #定义端口映射
          - "6379:6379"
    
      redis-slave1:
        image: redis:latest
        command: redis-server --slaveof redis-master 6379 --appendonly yes
        depends_on:
          - redis-master
        volumes:
          - ./data/slave1:/data
    
      redis-slave2:
        image: redis:latest
        command: redis-server --slaveof redis-master 6379 --appendonly yes
        depends_on:
          - redis-master
        volumes:
          - ./data/slave2:/data
    
      redis-sentinel1:
        image: redis:latest
        command: redis-sentinel /etc/redis/sentinel.conf
        depends_on:
          - redis-master
        volumes:
          - ./sentinel1.conf:/etc/redis/sentinel.conf
    
      redis-sentinel2:
        image: redis:latest
        command: redis-sentinel /etc/redis/sentinel.conf
        depends_on:
          - redis-master
        volumes:
          - ./sentinel2.conf:/etc/redis/sentinel.conf
    
      redis-sentinel3:
        image: redis:latest
        command: redis-sentinel /etc/redis/sentinel.conf
        depends_on:
          - redis-master
        volumes:
          - ./sentinel3.conf:/etc/redis/sentinel.conf
    #!/bin/bash
    docker-compose up --build
  • 示例二:基于dockerfile
    version: '3'
    services:
      app:
        build: 
          context: .
          dockerfile: Dockerfile
        ports:
          - "8080:8080"
    Dockerfile文件
    # 使用官方的java镜像作为基础镜像
    FROM openjdk:8-jdk-alpine
    
    # 设置工作目录
    WORKDIR /app
    
    # 将本地的jar包复制到Docker镜像中
    COPY ./your-app.jar /app
    
    # 设置启动命令
    ENTRYPOINT ["java", "-jar", "/app/your-app.jar"]

Docker

常见命令

  • 之间的关系:
    常见命令与他们之间的关系
  • 使用format对ps的结果进行格式化,更容易观察
    docker ps -a --format "table {{.ID}}\t{{.Image}}\t{{.Ports}}\t{{.Status}}\t{{.Names}}"
  • 可以通过编辑/root/.bashrc文件去给常用的命令起别名
    # 修改/root/.bashrc文件
    vi /root/.bashrc
    内容如下:
    # .bashrc
    
    # User specific aliases and functions
    
    alias rm='rm -i'
    alias cp='cp -i'
    alias mv='mv -i'
    alias dps='docker ps --format "table {{.ID}}\t{{.Image}}\t{{.Ports}}\t{{.Status}}\t{{.Names}}"'
    alias dis='docker images'
    
    # Source global definitions
    if [ -f /etc/bashrc ]; then
            . /etc/bashrc
    fi
  • 网络问题:
    - 容器的ip是一个虚拟ip,其值并不与容器绑定
    - 可以使用docker的网络功能实现容器的互联

Java新特性面试

Java8

  • 接口:interface 中可以有默认方法,无需被子类实现,通过Interface实现调用
  • “函数式接口”是指仅仅只包含一个抽象方法,但是可以有多个非抽象方法(也就是上面提到的默认方法)的接口。
    1. default实现,可以被子类继承重写,使用this调用
    2. static实现使用方法和静态方法一样,但是不能被子类继承
    3. interface和abstract class的区别:interface是为了快速扩展功能,而abstract class是为了被继承实现的。
      public class Main implements InterfaceNew{
      
          public static void main(String[] args) {
              InterfaceNew.sm();
              //调用df方法
              Main main = new Main();
              main.df();
          }
      }
      /**
       * InnerMain
       */
      interface InterfaceNew {
          static void sm() {
              System.out.println("interface中的sm实现");
          }
          
          default void  df() {
              System.out.println("interface提供的df实现");
          }
      }
  • Lambda
  • Stream:不存储数据,只是对数据进行一系列的处理
    • 串行流:
      • .stream() 为集合创建串行流
    • 并行流:可以多线程执行
      • parallelStream()获得并行流
    • API:
      • forEach() 迭代每个数据
      • map()传入函数作为变量,对每个数据进行映射(处理)
      • limit() 获取指定数量的流
      • sorted() 对流进行排序
      • Collectors 提供很多归约操作,可以讲将流转化为集合或者聚合元素,要配合collect()来实现
      • count()返回流的的数据
      • distinct() 返回一个去除重复元素的流
      • anyMathch() 检查是否有满足条件的元素,返回值为boolean
      • allMatch() 检查是否所有元素都满足匹配的条件
      • noneMathc()都不符合匹配条件
      • findFirst() 返回流中的第一个元素
      • findAny()返回流中的任意元素,这个任意元素只有在多线程中可以看出不同,他会任何线程中选择一个元素返回
      • reduce() 将流中元素合并成一个元素 numbers.stream().reduce((n1, n2) -> n1 + n2);
      • filter()过滤
  • Optional:用于避免空指针
    • Optional .ofNullable()返回一个包含指定值Optional对象,如果值为null,则返回一个空的Optional对象
    • isPresent() Optional不为空,返回true
    • get()返回值
    • ifPresent() 如果不为空,可以以调用指定的方法
    • orElse(默认值) 如果为空返回这个默认值
    • orElseGet() 如果为空调用指定的函数
    • filter() 过滤,如果不满足,返回一个空的Optional
    • map() 如果对象是Optional,那么就执行给定的函数
    • flatMap()将Optional展开,不再包装成嵌套的Optional

Java9

  • JShell 类似于python实时命令行交互工具
  • G1成为默认的垃圾回收器
  • String使用byte[ ]作为底层,节省空间

Java10

  • var关键字局部变量 ,主要作用是,当类型特别长时,可以使用var替代
  • Optional增加了orElseThrow来在没有值时抛出指定的异常

Java17

-

多线程

#todo

基本概念

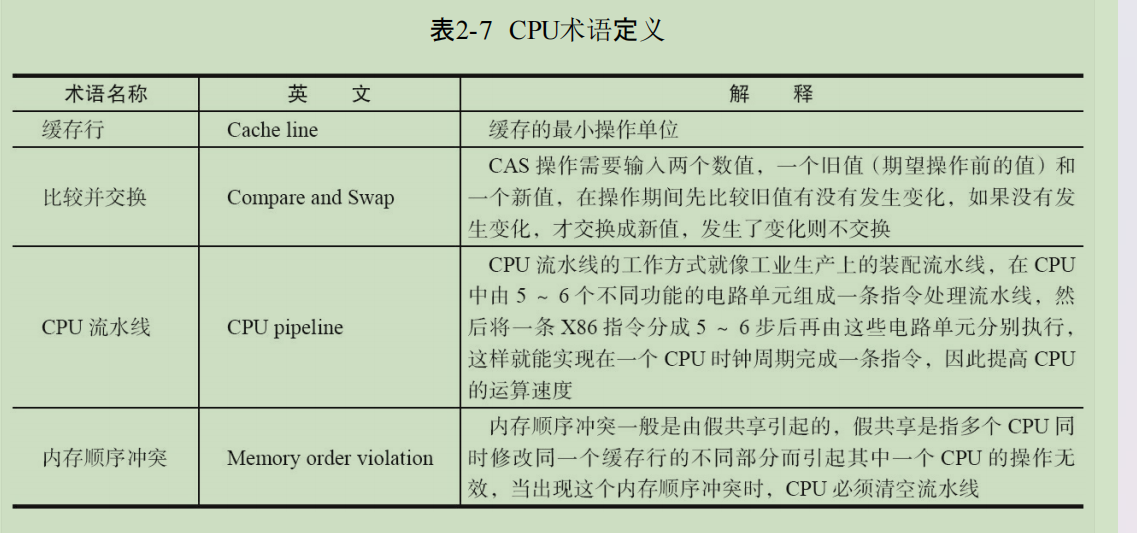
  1. CAS (Compare-And-Swap,比较并交换),是一种用于实现多线程同步的原子操作。主要原理:1.比较内存中的某个位置的当前值和预期值 2.交换如果当前值与预期值相等,则将该位置的值更新为新值,否则不进行任何操作。
    • 因为是原子操作所以在多线程中很高效。可以实现无锁编程,避免了上下文切换的开销。
    • 缺点是如果CAS操作失败后,通常会进行自旋,消耗CPU资源。
  2. 自旋:当一个线程尝试获取锁但是所以经被其他线程获取时,该线程不会进入睡眠模式,而是会在一个循环中不断的检查锁的状态,直到锁被释放,这种方式叫做自旋。
    • 优点是:低开销,可以避免线程上下文切换的开销,因为线程不会进入睡眠状态。适用于短时间的锁定,因为时间段,自旋等待的开销可能比线程切换开销更低。
    • 缺点是:CPU消耗搞,自旋不断等待占用CPU,也不适合长时间锁定,因为线程会长时间占用CPU资源进行无效的检查。
  3. 并发:一段时间内进行 并行:同一时刻同时进行

原子操作

处理器如何实现原子操作的

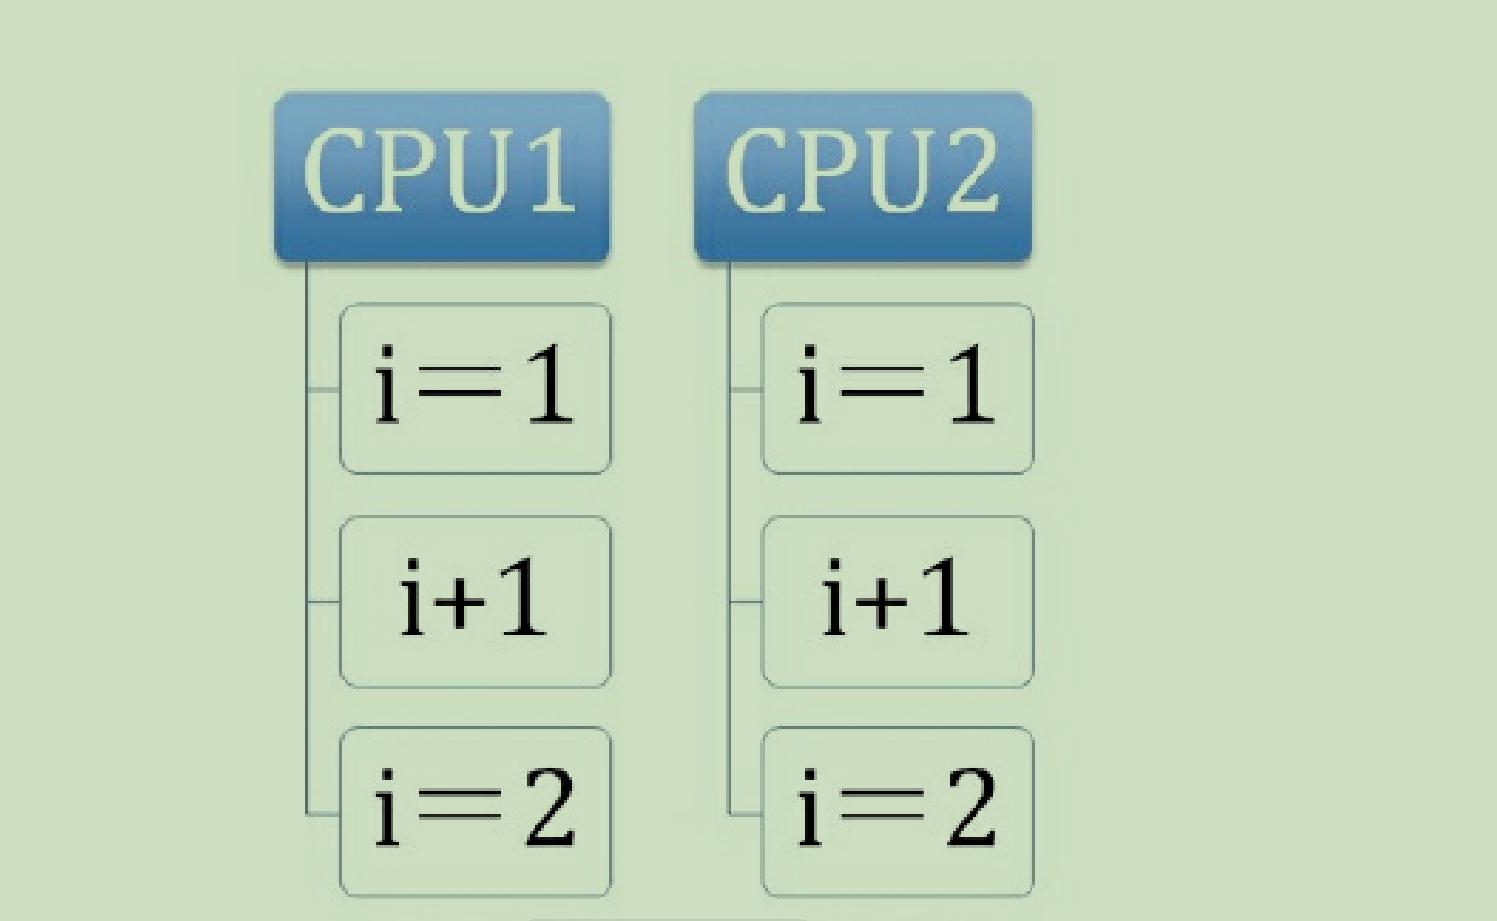
  1. 使用总线锁来保证原子性:如果多个处理器同时对共享变量进行读改写操作(例如i++),共享会被多个处理器同时进行操作,导致共享变量的值与期望不同。因为他们会从自己的缓存中读取变量i,然后分别进行+1,之后分别写入系统内存中
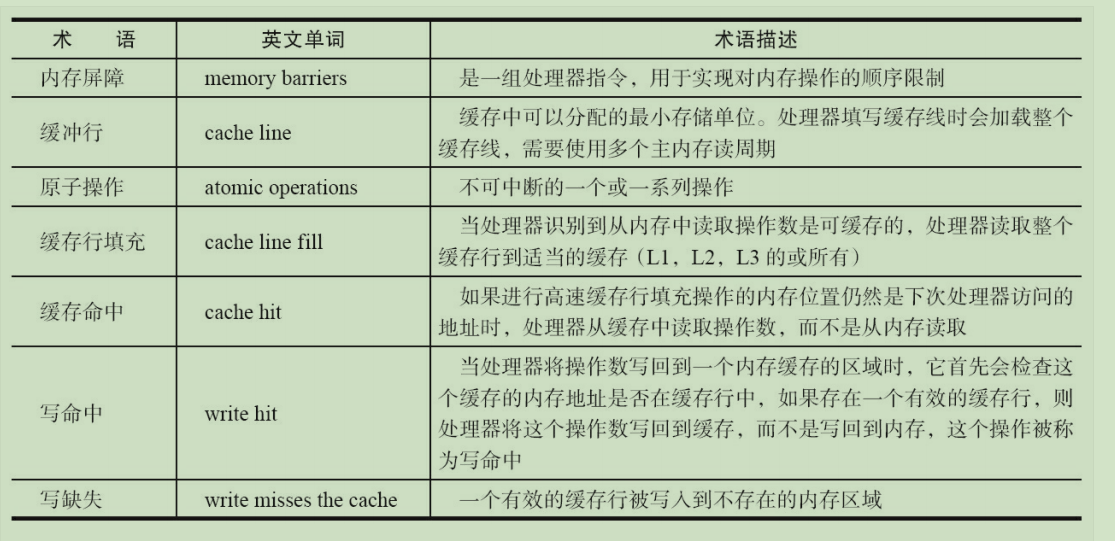
    • 处理器总线锁:使用了处理器提供的LOCK#信号,当一个处理器在总线上发出这个信号,其他处理器的请求将被阻塞住。从而实现独占共享内存。
  2. 使用缓存锁:总线锁会导致其他处理器不能处理其他内存地址的数据,我们只需要保证对某个内存地址的操作是原子的就行。
    • 频繁使用的内存会缓存在处理器的L1、L2、L3高速缓存中。
    • 缓存锁定:缓存锁定是某个CPU对缓存数据进行更改时,会通知缓存了该数据的该数据的CPU抛弃缓存的数据或者从内存重新读取。

多线程就一定快吗?

不一定,因为线程切换涉及到上下文切换和线程创建的开销

如何减少上下文的切换次数

  1. 无锁并发编程:避免使用锁,利用将数据的ID按照Hash算法取模运算,不同线程处理不同段的数据
  2. CAS算法:不需要加锁
  3. 使用最少线程:避免创建不需要的线程
  4. 协程:单线程中实现多任务的调度,并且再单线程中维持多个任务间的切

资源限制

并发编程中,如果多线程占用的资源超过系统资源的限制,实际上仍然是串行执行的,而且因为有上下文切换的影响,反而会更慢

如何避免死锁

  1. 避免一个线程同时获得多个锁
  2. 避免一个线程在锁内同事占用多个资源,尽量保证每个锁只占用一个资源
  3. 尝试使用定时锁 lock.tryLock(timeout)来替代内部锁机制
  4. 对于数据库锁,枷锁和解锁必须在一个数据库连接里,否则会出现解锁失败的情况

常用的线程分析工具

vmstat

常用指令,具体的参数自己去搜,这里主要看的是cs指标,代表每秒上下文切换次数

vmstat [delay] [count] 后面参数可选
每隔delay秒输出一次统计信息,总共输出count次
vmstat -s 显示系统的累计统计信息
	   -d 显示统计信息
	   -p +指定分区 显示指定分区的统计信息
	   -a 显示活动内存和非活动内存的信息
	   -m 显示slabinfo信息(`slabinfo` 是 Linux 内核中用于显示 slab 分配器(slab allocator)信息的工具)
	   -t 在输出中添加时间戳

Java中的多线程

当在一个JVM进程里面开多个线程时,这些线程被分成两类:守护线程和非守护线程。默认开的都是非守护线程。在Java中有一个规定:当所有的非守护线程退出后,整个JVM进程就会退出。意思就是守护线程“不算作数”,守护线程不影响整个 JVM 进程的退出。例如,垃圾回收线程就是守护线程,它们在后台默默工作,当开发者的所有前台线程(非守护线程)都退出之后,整个JVM进程就退出了。

Wait方法为什么不定义在Thread中?

Wait释放的锁是写在Java对象头中,所以是写在Object中而非当前线程

锁的分类和对比

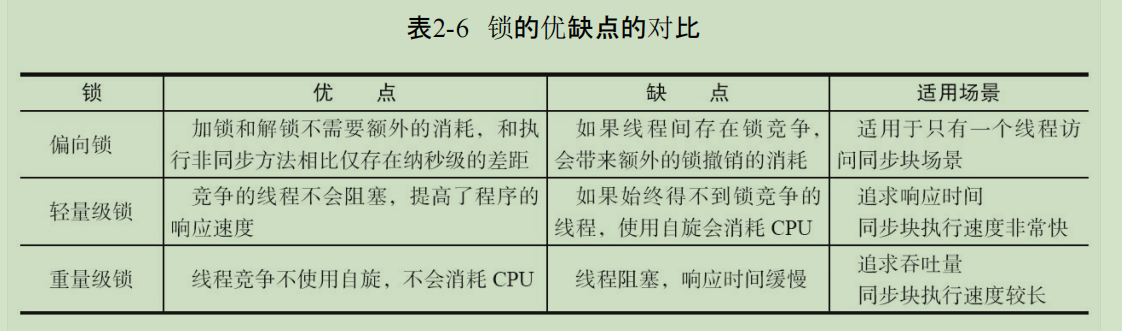
Java中锁存在四种状态

  1. 无锁状态
  2. 偏向锁状态
  3. 轻量级锁状态
  4. 重量级锁状态
    锁可以升级但是不能降级,这种设定能够提高获得锁和释放锁的效率

偏向锁

大多数情况下锁不仅不存在多线程竞争,而且总是由同意线程多次获得。
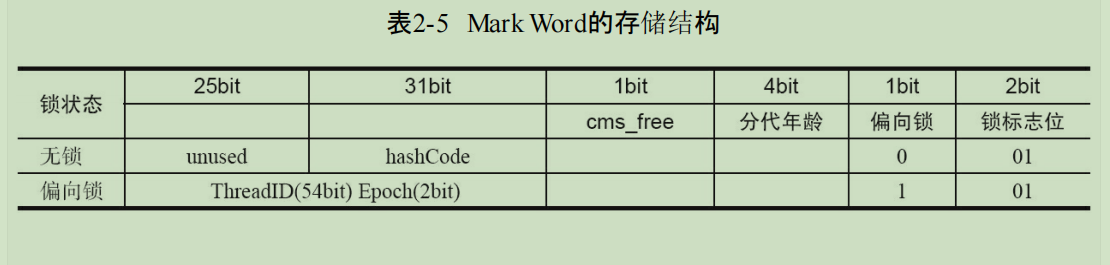
当一个线程访问同步块并且获得锁时,会在对象头和栈帧中的锁记录里面存锁偏向的线程ID,以后该线程进入/推出额同步块块时,不需要进行CAS来进行枷锁和解锁,只需要测试对象头Mark Word里是否存储着这项当前线程的偏向锁。
如果测试失败就看偏向锁的标识是否为1,1是偏向锁,如果不是就用CAS竞争锁,否则尝试使用CAS将偏向锁设置为当前线程

偏向锁的撤销
  1. 偏向锁只有其他线程尝试竞争偏向锁时持有偏向锁的线程才会释放锁。
  2. 偏向锁的撤销,需要在全局安全点(在这个事件电商没有正在执行的字节码),会先暂停拥有偏向锁的线程,然后检查持有偏向锁的线程是否或者,如果线程处于不活跃状态,则将对象头设置成无锁状态;如果线程仍然存活,则拥有偏向锁的栈会被执行,便利偏向对象的锁记录,要么重新偏向其他线程,要么恢复到无锁或者标记独享不适合作为偏向锁,最后唤醒暂停的线程。

轻量级锁

加锁

线程在执行同步块之前,JVM会在当前线程的栈帧中创建用于存储锁记录的空间,并且将对象头中的Mark Word复制到锁记录中(Displaced Mark Word替)。然后线程尝试使用CAS将对象头中的Mark Word替换为只想所记录的指针。如果成功,当前线程获得锁,如果失败,尝试使用自旋来获得锁。

解锁

会使用原子的CAS操作将Displaced Mark Word替换回对象头。如果成功则说明没有竞争发生,如果失败,标识当前锁存在竞争。锁会升级成重量级锁。

volatile

volatile是轻量级的synchronized,保证了共享变量的可见性,同时不会引起上下文的切换和调度。
但是i++不能保证原子性的,因为i++是读写两次操作。
JVM中并没有要求64位long/double写入是原子的。所以多线程读取时又可以读到的是”一半”的值。这个时候就需要使用volatile了

主要功能

  1. 保证单词写入/读入原子性
  2. 内存可见性
  3. 禁止重排序

前置概念

volatile是如何实现的?

  1. 转变成汇编语言之后会多一个Lock前缀,这个前缀会将当前处理器缓存行的数据写回系统内存,同时其他CPU中缓存了该内存地址的数据无效。修改volatile变量会强制将修改之后的值刷新到内存中同时导致其他线程中的该变量值失效。
  2. 处理器会根据MESI(修改、独占、共享、无效)控制协议去维护内部缓存。处理器使用嗅探技术保证它的内部缓存、系统内存和其他处理器的缓存的数据在总线上保持一致。

可见性:
修改volatile变量会强制将修改之后的值刷新到内存中
同时导致其他线程中的该变量值失效。
有序性:遵循happen-before
内存屏障:JVM通过内存屏障来实现的

内存屏障

CPU防止代码进行重排序而提供的指令。
Unsafe提供了以下的内存屏障方法

//内存屏障,禁止load操作重排序。屏障前的load操作不能被重排序到屏障后,屏障后的load操作不能被重排序到屏障前
public native void loadFence();
//内存屏障,禁止store操作重排序。屏障前的store操作不能被重排序到屏障后,屏障后的store操作不能被重排序到屏障前
public native void storeFence();
//内存屏障,禁止load、store操作重排序
public native void fullFence();

重排序问题

执行程序时,为了提高性能编译器和处理器常常会对执行进行重排序。

  1. 编译器优化的重排序:不改变单线程语义的情况下,可以重新安排语句的执行顺序
  2. 指令级并行的重排序:现代处理器采用了指令级并行技术来讲多条指令重叠执行。如果不存在数据依赖性,处理器可以改变语句对应机器指令的执行顺序。
  3. 内存系统的重排序:由于处理器使用缓存和读/写缓冲区,是的加载和存储操作看上去可能时再乱序执行

as-if-serial

多线程程序中的重排序,编译器和CPU只能保证每个线程的线程内部之间都是“看似完全串行的”,但是多个线程会相互读取和写入共享的变量不会进行考虑。

happen-before

保证一个线程的执行结果对另一个线程可见。
#todo

  • synchronized原理

synchronized

是可重入的吗

可重入(Reentrant)是指在多线程环境中,一个函数可以被多个线程同时调用而不会引起任何问题。

是可重入的,因为synchronized关键字是基于JVM内部的监视器锁,这种锁是依赖于对象头中的标记字段来管理锁的状态。
当线程第一次获得锁时,他的线程ID会被记录在对象头的标记字段中,并且计数器设置为1,如果同一线程需要再次进入由自己持有锁的synchronized块时,计数器就会+1,当synchronized块时,计数器-1。当计数器回到0时,锁才真正被释放,此时其他线程可以尝试获取这个锁。

synchronized可以锁的类型

  1. 对于普通同步方法,锁的是实例对象
  2. 对于静态同步方法,锁的是当前类的Class对象,包括这个类的所有对象
  3. 对于同步方法块,锁的是Synchornized括号里的对象

实现和原理

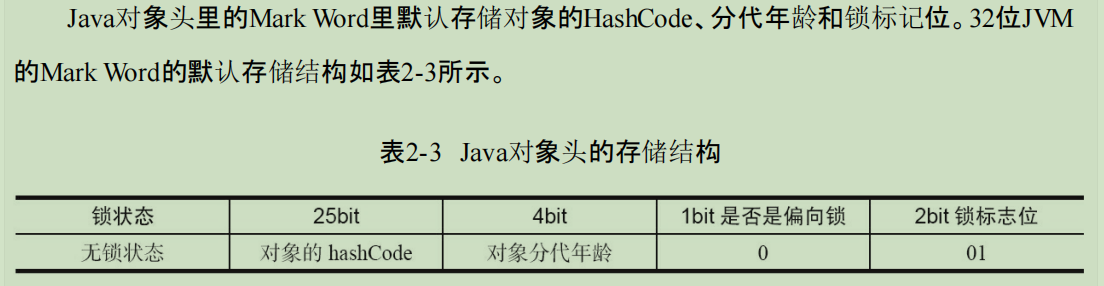
  1. synchronized用的锁是存在Java对象头里的,如果对象是数组类型,则虚拟机用三个字宽存储对象头。
  2. 对象头会随着锁标志位的变化而变化 对象头会随着锁标志位的变化而变化

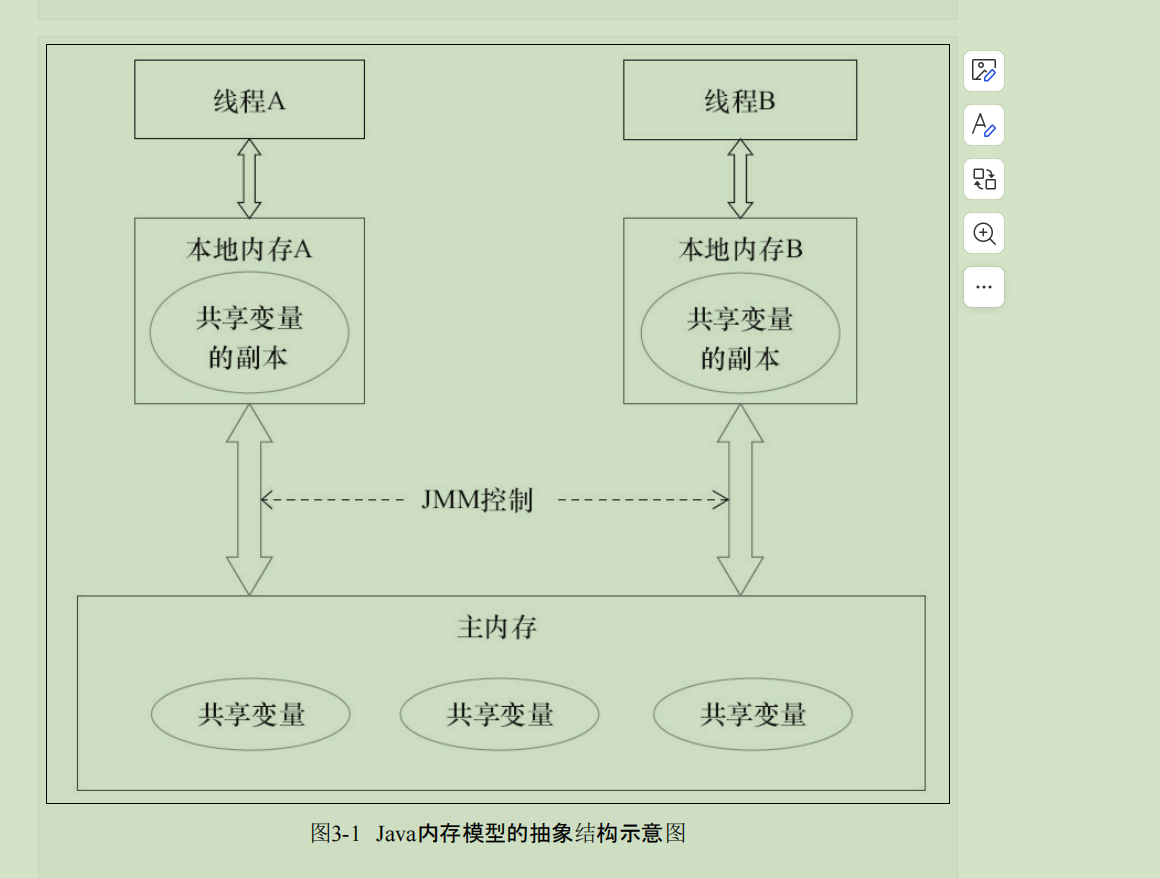
Java内存模型的基础

并发编程中常常需要解决线程之间如何进行通信和如何进行同步。
在命令式编程中,线程之间的通信机制有两种:共享内存和消息传递。

共享内存是线程共享程序的公共状态,通过读写内存的公共状态来进行通信。消息传递则是线程之间必须通过发送消息来显示的进行通信。

Java中使用的是共享内存模型。
他们之间的通信需要修改共享变量,然后由另一个去读取共享变量来实现。
JDK5 开始,Java使用JSP-133内存模型,使用happens-before:前一个操作的结果对后一个操作可见

CountDownLatch

什么是CountDownLatch?

CountDownLatch 是通过一个计数器来实现的,计数器的初始值就是线程的数量,每当一个线程执行完毕之后,计数器的值就-1,然后在闭锁上等待的线程就可以恢复工作了。
主要使用场景:

  • 用于等待多个线程完成一个整体的前提任务
    实例:在进行业务之前将两个数据库中的数据进行同步(非集群的数据库)
    import java.util.concurrent.CountDownLatch;
    
    public class DatabaseSync {
    
        public void syncDatabase1() {
            // 这里是同步数据库1的代码
        }
    
        public void syncDatabase2() {
            // 这里是同步数据库2的代码
        }
    
        public void sync() throws InterruptedException {
            CountDownLatch latch = new CountDownLatch(2);
    
            new Thread(() -> {
                syncDatabase1();
                latch.countDown();
            }).start();
    
            new Thread(() -> {
                syncDatabase2();
                latch.countDown();
            }).start();
    
            // 等待两个数据库同步操作完成
            latch.await();
            System.out.println("Both databases have been synchronized.");
        }
    
        public static void main(String[] args) throws InterruptedException {
            new DatabaseSync().sync();
        }
    }

JUC包

CompletableFuture

Future的缺点:不支持异步任务的编排,同时get方法是阻塞调用
完全可控的Fututure
使⽤线程池时,我们应该尽量避免将耗时任务提交到线程池中执⾏。对于⼀些⽐较耗时的操作,如
⽹络请求、⽂件读写等,可以采⽤ CompletableFuture 等其他异步操作的⽅式来处理,以避
免阻塞线程池中的线程
示例代码:

CompletableFuture<Map<String, Map<String, Object>>> future = CompletableFuture.supplyAsync(() -> adminClient.distributedInstance());

CompletableFuture源码分析

  • runAsync不允许返回值,适合需要一步操作但是不关心返回结果
  • supplyAsync需要返回值,适合需要返回值的异步操作
  • thenApply、thenAccept、thenRun、whenComplete 可以对结果进行进一步处理
  • 异常处理使用handle
  • 合并future结果,thenCompose是链接两个CompletabelFuture,并将前一个结果作为下一个任务参数,thenCombine会将两个任务都结束之后,将两个任务的结果合并,并行执行
  • allOf等待所有的执行完成之后再调用
    默认使用的是ForkJoinPool.commonPool作为执行器,这个线程池全局共享,可能会被其他任务占用

ConcurrentHashMap

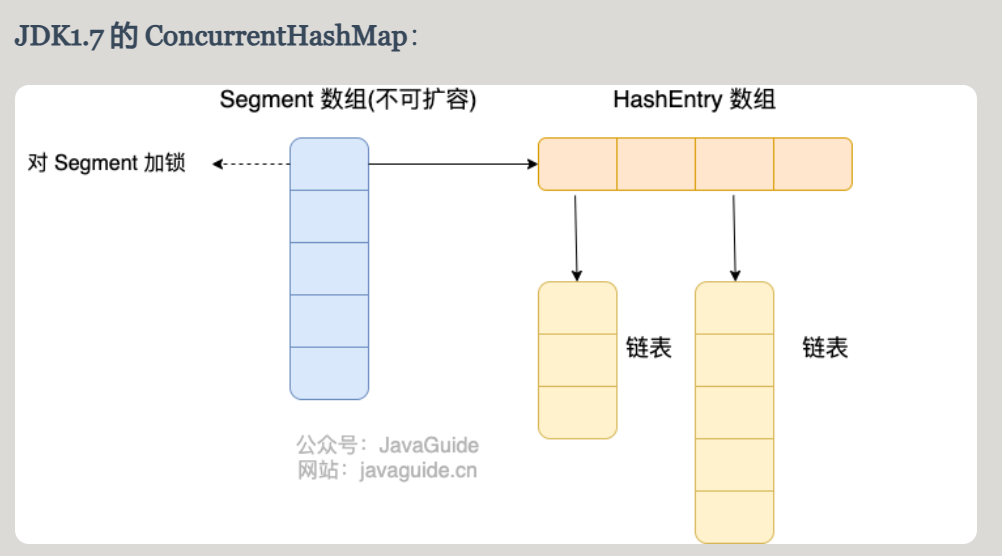
线程安全的HashMap,多线程情况下HashMap进行put操作会进入死循环。而使用HashTable效率又很低,因为当一个线程访问HashTable的同步方法,其他线程也访问时,会进入阻塞或轮询状态,所有的线程都必须竞争同一把锁。而我们只需要有多把锁,每一把锁都只锁住某一部分数据即可。这就是ConcurrentHashMap使用的锁分段技术。
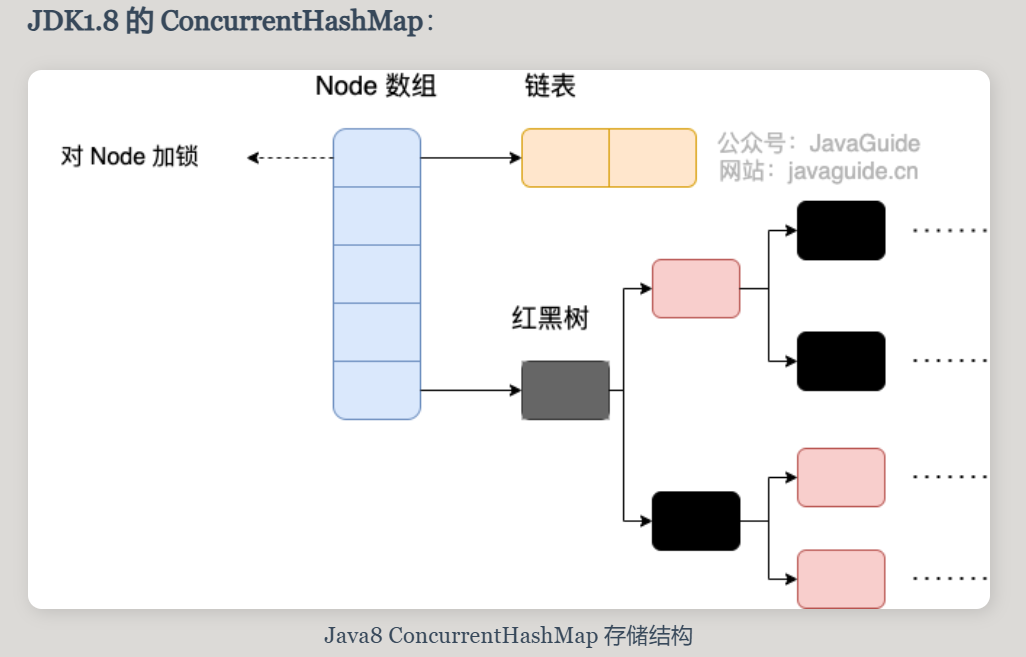
JDK1.7使用的是分段的数据+链表实现的,JDK1.8使用的数据结构跟HashMap一职,数组+链表/红黑树。使用的是Node数组+链表+红黑树,通过synchronized和CAS操作来帮正线程安全

实现原理 具体看源码

1.7

Segment数组(不可扩容) 作为分段锁,是可重入锁,对其中的一部分加锁

1.8

使用的是Node数组+链表/红黑树,Node只适用于链表的情况,而红黑树需要TreeNode。使用Node+CAS+synchronized来保证线程安全

常用的api
get

先进性一次散列,然后使用这个散列值定位到Segment,再进行散列定位到元素。
get不需要加锁,因为get方法中使用的共享变量都顶i成volatile类型,额能够在线程之间保持可见性。保证不会读到过期的值,但是只能被单线程写(如果写入的值依赖原值)
根据happen before原则,对volatile字段的写是优先于读的。

put

对共享变量进行写入操作,为了线程安全必须加锁。
先定位到Segment,之后再Segment里进行操作,所以只需要锁住一个Segment即可
扩容机制:只会对某个segment进行扩容。

count

先尝试不加锁来统计各个Segment的大小,如果两次中出现了不同的数值,就采用加锁的方式来统计所有Segment大小。
原理是格局modCount变量,put、remove、clean方法都会把modCount+1

CopyOnWriteArrayList

线程安全的 List,用来替代Vector
Vector的核心思想是每次访问都上锁,使用synchronized进行加锁,会导致性能很差
而CopyOnWriteArrayList则是使用了跟读写锁相似的思想,读读不互斥。写不会堵塞读取操作,只有写写才会出现互斥,核心思想是写时复制:不会直接修改原数组,而是先创建底层数组的副本,对副本进行修改,修改完之后再将修改后的数据赋值回去。

ConcurrentLinkedQueue

线程安全的队列,是非阻塞实现的

实现原理

入队
使用CAS算法实现的

  1. 定位尾节点
  2. 使用CAS算法来不断尝试将节点加入队列:如果尾节点的next是null表示已经是尾节点了,如果不是说明其他县城更新了尾节点,需要重新或如当前队列的尾节点。
    出队
    先获得头节点的元素,判断头节点元素是否为空,如果为空就是已经被别的线程取走,如果不为空就用CAS尝试出队

BlockingQueue

有多种实现
值得注意的时Pirority和Delay
阻塞队列,当队列满时,队列会阻塞插入元素的线程,之道队列布满。
当队列为空时,获取元素的线程会等待队列变成非空
常用于成缠着消费者问题

实现原理

通知模式实现

通知模式是生产者往满的队列中添加队列时会阻塞住生产者。当消费者消费了一个队列中的元素后,会通知生产者当前的队列可用

CountDownLatch

示例代码

public class Main {

    static CountDownLatch countDownLatch = new CountDownLatch(2);
    public static void main(String[] args) throws InterruptedException {
        new Thread(()->{
            System.out.println("1");
            countDownLatch.countDown();
            System.out.println("2");
            countDownLatch.countDown();
        }).start();
        countDownLatch.await();
        System.out.println("3");
    }
}

CyclicBarrier

同步屏障
功能是让一组线程到达一个屏障(同步点)时被阻塞,直到最后一个线程到达屏障时才开门,所有被阻塞的线程才会继续运行。
与CountDownLatch的区别:countdownlatch只能使用一次,计数器无法重置。cyclicbarrier可以多次重复使用,当所有的线程到达同步点之后屏障会重置。

CyclicBarrier:用于让一组线程互相等待,直到所有线程都到达某个屏障点,然后所有线程再继续执行。可以重用。
CountDownLatch:用于一个或多个线程等待其他线程完成某些操作。不能重用。

二者使用方法相似
如何选择:
简单的一次性同步任务可以使用countdownlatch,例如初始化一些配置
多阶段反复同步线程或者并发任务需要分阶段执行,每个阶段都需要等待所有的线程完成,选择cyclicbarrier

Semaphore

信号量,控制同时访问特定资源的线程数量。

Exchanger

进行线程之间协作的工具类。提供一个同步点,两个线程可以在这个同步点交换彼此的数据。

原子类

Atomic包

Java中的线程池

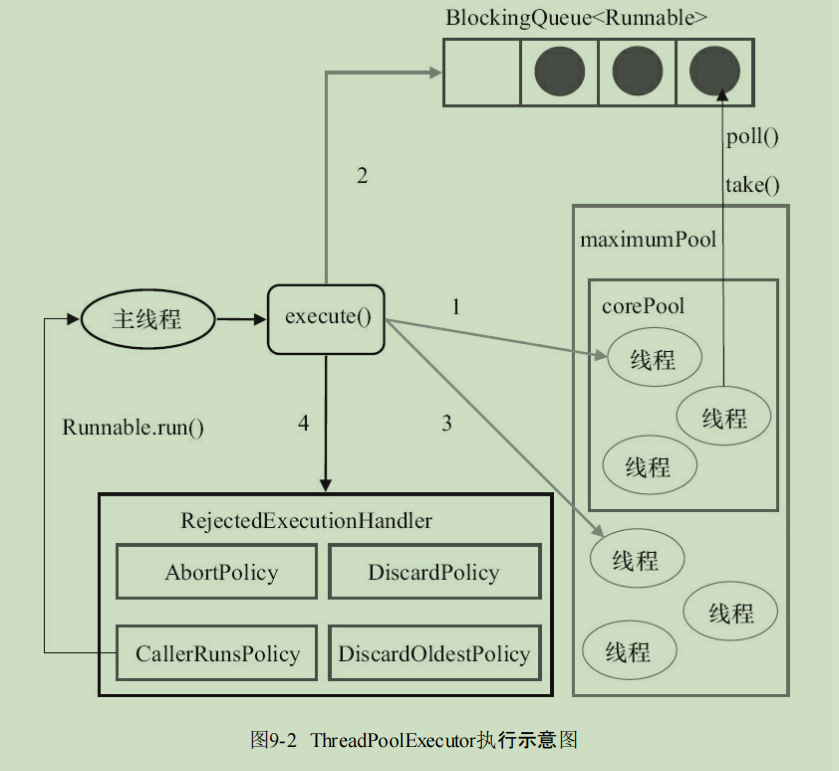
实现原理

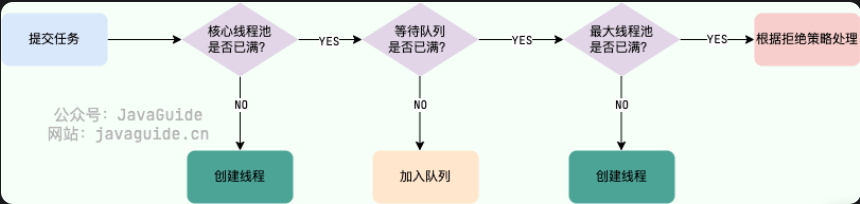
  1. 判断核心线程池里的线程是否都在执行任务,如果不是则新建一个工作线程来执行任务;如果都在执行任务,则进入下一个流程
  2. 判断工作 队列是否已经满,如果没满,将新提交的任务存储在这个工作队列里,如果满了,进入下一个流程
  3. 判断线程池中 当线程是否都在工作中,如果没有就创建一个新的工作线程来执行任务,如果已经满了,则交给饱和策略来处理这个任务

核心参数

  1. 核心线程数:任务队列没满时可以同时执行的最大线程数
  2. 最大线程数:任务队列满时,可以同时运行的线程数
  3. 线程空闲时间:线程数量超过核心线程数时,多余的空闲线程再中止前等待新任务的最长时间
  4. 时间单位
  5. 任务队列:
  6. 线程工厂
  7. 拒绝策略:当任务无法提交到线程池时的处理策略。
    • AbortPolicy:抛出 RejectedExecutionException 异常(默认策略)。
    • CallerRunsPolicy:由调用线程处理该任务。
    • DiscardPolicy:直接丢弃任务。
    • DiscardOldestPolicy:丢弃队列中最旧的任务,然后重新提交新任务。

任务执行顺序

  1. 当前运行中的线程数小于核心线程数,就新建一个线程来执行任务,即使线程池中存在空闲线程
  2. 如果大于等于核心线程数,但是小于最大线程数,就把任务加入到任务队列中
  3. 如果队列已满,但是线程数小于最大线程数,就新建一个线程来执行任务
  4. 如果新创建线程会导致当前运行中的线程数大于最大线程数,就会调用拒绝策略

生产者-消费者模型:

一个内存队列,多个生产线程往内存队列中放数据,多个消费者线程从内存对俄中取数据。

  1. 内存队列本身需要枷锁,才能实现线程安全
  2. 阻塞。当内存队列满了,生产者被阻塞,内存队列为空时消费者被阻塞。
  3. 双向通知:消费者被阻塞之后,生产者放入新数据,要通知消费者,反之要通知生产者。

Unsafe

主要功能

  1. 内存屏障

ReenTrantLock

实现原理

实现是一种自旋锁,使用循环调用CAS操作来进行加锁。

线程同步的方法

  1. Synchronized
  2. ReentrantLock
  3. CountDownLatch
  4. CyclicBarrier
  5. Semaphore
  6. Wait和No

#todo

  • 加上书签

Fork/Join与线程池的区别

核心是ForkJoinPool,使用的是工作窃取方来平衡

AQS (AbstactQueuedSynchronizer)

是一个抽象类,提供了线程同步的底层实现机制,

一、什么是循环依赖?

在Spring项目中我们经常使用 @Autowired或者@Resource去注入Bean,我们称之为依赖。
当多个Bean之间存在互相依赖的关系,并且出现了循环调用时,Spring就会找不到依赖的七点,就会死循环直到抛出异常。
例如:A依赖B,B依赖C,C依赖A,三者必须在依赖的类初始化之后才会初始化自己,从而出现死循环。

二、实战场景

笔者是在使用Spring Security 编写登录和权限验证代码时出现了循环依赖的场景。

三、解决方法

省流: 笔者使用的方法

  1. 使用@Lazy延迟创建对象
  2. 将@Resource替换为@Autowired
  3. 新建一个空Bean,来解决依赖问题: 例如 A依赖B,B依赖A,我们可以新建一个C,然后让A依赖C,B实现C即可将直接依赖转化为间接依赖关系 中介方式打破循环链
    // 新的接口
    public interface C {
        void doSomething();
    }
    
    // B实现C
    public class B implements C {
        @Override
        public void doSomething() {
            // ...
        }
    }
    
    // A依赖C,而不是直接依赖B
    public class A {
        private C c;
    
        public A(C c) {
            this.c = c;
        }
    
        public void doSomething() {
            c.doSomething();
        }
    }

四、扩展:@Autowired是如何解决循环依赖的的问题的

解决的核心是使用了Spring的三级缓存:

  • 第一级缓存:singletonObjects,用于存放完全初始化好的bean,避免重复创建,单例池
  • 二级缓存:earlySingletonObjects 存放原始的bean对象,尚未填充属性,同时也没有进行完成依赖注入的类 (核心)
  • 三级缓存:singletonFactories 用于存放bean工厂对象中的getObject方法,用于产生原始的bean或者代理对象(如果Bean被AOP切面代理)来放入二级缓存
    首先我们要知道,实例化 ≠ 完全初始化,当Spring容器创建bean时,会从一级缓存中寻找,如果没找到,会搜索二级缓存,如果存在就会把它注入,如果没有会找三级缓存。当bean初始化时,如果发现依赖的类没有完成完全初始化,就会先使用二级缓存中的bean实例,当所有的bean都初始化之后再从一级缓存中获取完全初始化的bean
    而我们使用的@Resource并不存在这种机制,会直接抛出BeanCurrentlyInCreationException
    只用两级缓存可以吗?
    如果没有AOP的情况下只是用一级和三级缓存就能解决,但是涉及到AOP时,必须使用了
    如果发生循环依赖的话,就去 三级缓存 singletonFactories 中拿到三级缓存中存储的 ObjectFactory 并调用它的 getObject() 方法来获取这个循环依赖对象的前期暴露对象(虽然还没初始化完成,但是可以拿到该对象在堆中的存储地址了),并且将这个前期暴露对象放到二级缓存中,这样在循环依赖时,就不会重复初始化了!

Tigs:

  1. 相同的application文件优先使用公共的配置

一些没什么用的小概念

  • 并发量:同一时间内,系统中同时处理的用户请求数
  • 响应时间:系统处理一个请求所需的时间
  • 吞吐量:系统在给定时间内处理处理的业务请求数量
  • QPS(Queries Per Second) 表示系统每秒钟处理的请求数量
  • TPS(Transactions Per Second ) 表示系统每秒钟完成的事务数量

Gateway 网关负责分发前端请求

使用分布式锁来解决缓存击穿

  • 以下是要自己完成的:
    1. 使用Spring Security和GateWay完成路由转发和认证
    2. 使用kafka或rocketmq
      Redis作为缓存
  • 缓存问题:
    1. 每天的用户很多但是用户每天使用的次数很少,同时会员的信息涉及的表很多
      • 解决:使用本地缓存,因为每个会员使用次数很少,一分钟有效,
      • 问题:fullgc频繁,导致短时间内大量请求失败,因为缓存时间很短,所以大量的新生代出现,引起频繁的gc,然后大量放入老年代引起fullgc , 解决:不用本地缓存,而是用线程本地变量,放在内存中。

Senta

  • 原理:生成反向sql
  • 模式:
    1. AT模式:默认,添加undo_log,反向生成sql,回滚之后原来没数据的依然没有数据
      • 使用方法:
        1. 建立undo_log表
    2. TCC模式: try confirm/cancel 三个阶段的代码自己实现,Seata负责调度
    3. SAGA模式:长事务解决方案,需要编写两个阶段的代码,需要一个JSON文件,可以异步执行
    4. XA模式:适用于银行和金融,需要数据库支持XA协议
      try 之前的代码出现异常会直接结束,不会走finally

如何处理多并发的买票

  1. 使用synchronized ,缺点:会导致卡住,只适合单机
  2. 使用Redis分布式锁,使用日期+车次来作为锁key,然后放入Redis中,如果拿到锁则继续执行,使用的使setIfAbsent(key,value,timeout),如果这个锁不存在则设置并且返回true,买到票之后删除key 缺点:如果线程执行时间超过了超时时间,也会导致超卖 对应Redis的命令是setnx
  3. 使用Redisson看门狗,使用一个守护线程来关注超时间是,如果事务未完成但是锁即将过期则重置时间,如果事务结束则守护线程结束,lock.isHeldByCurrentThread来判断是否是当前线程的锁,缺点:Redis集群中Redis宕机,会导致获得得不到锁,然后新的线程向新的Redis主节点中获得锁,仍然可以获得锁 , 最常用 ,Redisson中的锁在释放了之后Redis就查不到了!!!
  4. 使用红锁:只有拿到半数以上的同等地位的Redis的锁才算拿到锁,Redisson中也有自带的红锁,不常用, 缺点:性能问题,并且如果都得不到锁就都会等待了,尽量去尝试获得更多的锁来解决单机宕机问题
@RestController
@Slf4j
public class RedisController {
    @Resource
    private RedissonClient redissonClient;

    @PostMapping("/buy")
    public String set(String ticket) throws InterruptedException {
        //当前日期
        String key = ticket ;
        log.info("key:{}", key);
        RLock lock = null;

            //获取锁
            lock = redissonClient.getLock(key);
            //尝试加锁,最多等待100秒,上锁以后10秒自动解锁
            boolean tryLock = lock.tryLock( 0, TimeUnit.SECONDS); //等待100秒,上锁以后10秒自动解锁
            log.info("tryLock:{}", tryLock);
            //模拟业务处理
            if(tryLock){
                Thread.sleep(10000); //单位是毫秒
                log.info("购买成功");
                if(null != lock && lock.isHeldByCurrentThread()){
                    lock.unlock();
                }
                return "购买成功";
            } else {
                log.info("没拿到锁");
                return "购买失败";
//                throw new RuntimeException("没拿到锁");
            }


    }
}

使用Sentinal进行限流和降级

  • 常见的限流算法:
    1. 静态窗口限流:每秒限制多少个请求,例如:第2.5会统计第2秒到现在的流量
    2. 动态窗口限流:滑动窗口,往前取1秒,例如:第2.5秒会统计第1.5秒到现在的请求数
    3. 漏桶限流:队列,请求全在队列中,出队是匀速的
    4. 令牌桶限流:放的是令牌,令牌就是计数,会有一个计数器匀速产生令牌,出队不是匀速的可以适应短时间内大量请求
    5. 令牌大闸:当令牌到达一定数量就不再产生新的令牌

如何应对刷票

使用令牌大闸:令牌按照匀速生成,即使有再多的机器人刷票也会被领票的数量限制,判断令牌肯定比更新库存更快

  1. 使用令牌锁,持有令牌锁的人才能对令牌进行操作
  2. 检测令牌数量,如果有就执行,没有就不能执行
  3. 不要立刻释放令牌锁,使用固定的时间来释放令牌锁,这样即使有机器人也得等待令牌锁的释放
  • 同时也可以加入验证码来防止机器人刷票
    优化:使用缓存加速令牌锁
    将数据库查出来的令牌存在Redis中,每次对Redis中的令牌数量-1,只有当数量等于我们设定的阈值时再去更改数据库的令牌数量,所以需要在Redis中长期保持这个key

使用RocketMQ

使用RocketMQ来完成
购票之后,将请求发送给RocketMQ,然后另一边去消费这个消息,并且进行数据库的增删改查,可以将请求直接转为String 发送,之后另一端pull然后转为需要的类,之后执行具体具体的逻辑

纯手写

  1. 登录:
    • 使用gateway + SpringSecurity + JWT + Redis实现微服务登录
    • Mybatis+Mybatis-plus

Elasticsearch学习笔记

Analyzer

Analyzer是ES中的一个组件,用于将输入的文本转化为索引时锁使用的文本特征向量。将文本分解,然后转化为特定的文本特征。

分片

分片就是将索引内部的数据分割成多个部分的机制,用于分布、存储和管理索引的数据 。允许索引被拆分为多个物理或逻辑部分从而实现分布式存储和处理数据的能力

面试常问:

  1. 索引文档的过程:
    1. 协调节点默认使用文档ID参与计算,为路由提供合适的分片,转发请求
    2. 分片所在节点接收到请求之后,将请求写入内存缓冲区,定时refresh到文件系统缓存,经过这一步既可以被搜索到了,当Filesystem cache中的数据写入到磁盘中时,才会清除掉translog,这个过程叫做flush;
    1. es的删除:es中的文件并没有删除,每个段都有一个.del文件,删除是在这里进行标志,该文档仍然能够匹配到,但是会在结果中被过滤掉,后续在执行merge(周期性的将较小的段合并为一个较大的段)操作时,会被彻底清除掉
    2. 更新:每次更新都是先标记旧的文档为已删除,重新建立一个文档,并通过版本号来区分
    3. 搜索过程:
      • Query Then Fetch
      1. 查询广播到每一个分片,分片本地执行搜索,建立一个优先队列,搜索只能搜到文件缓存的内容,所以并不是完全实时的
      2. 分片返回优先队列中文档的ID和排序值给协调节点,协调节点合并结果并排序
      3. 协调节点确定要取回的文档,然后向对应分片发送请求,最后协调节点返回给客户端
    4. 写过程:客户端选择一个node(作为协调节点)发请求,协调节点对文档进行路由,将请求转发给有这个文档的主分片的节点,主分片处理请求,并将将数据同步到副本中,之后协调节点根据完成状态,相应给客户端
    5. 读过程:协调节点根据doc id来查询,然后对doc id进行hash来确认到了哪个分片上,然后转发请求到对应的节点,使用负载均衡 来选取一个分片来处理,并转发给它,之后由这个节点来读取并返回给协调节点,协调节点返回给客户端
    6. es相对于mongodb,mysql的优势:1.全文检索,相关性排名 2.近实时性3.分布式处理4.数据分析 缺点:不支持事务
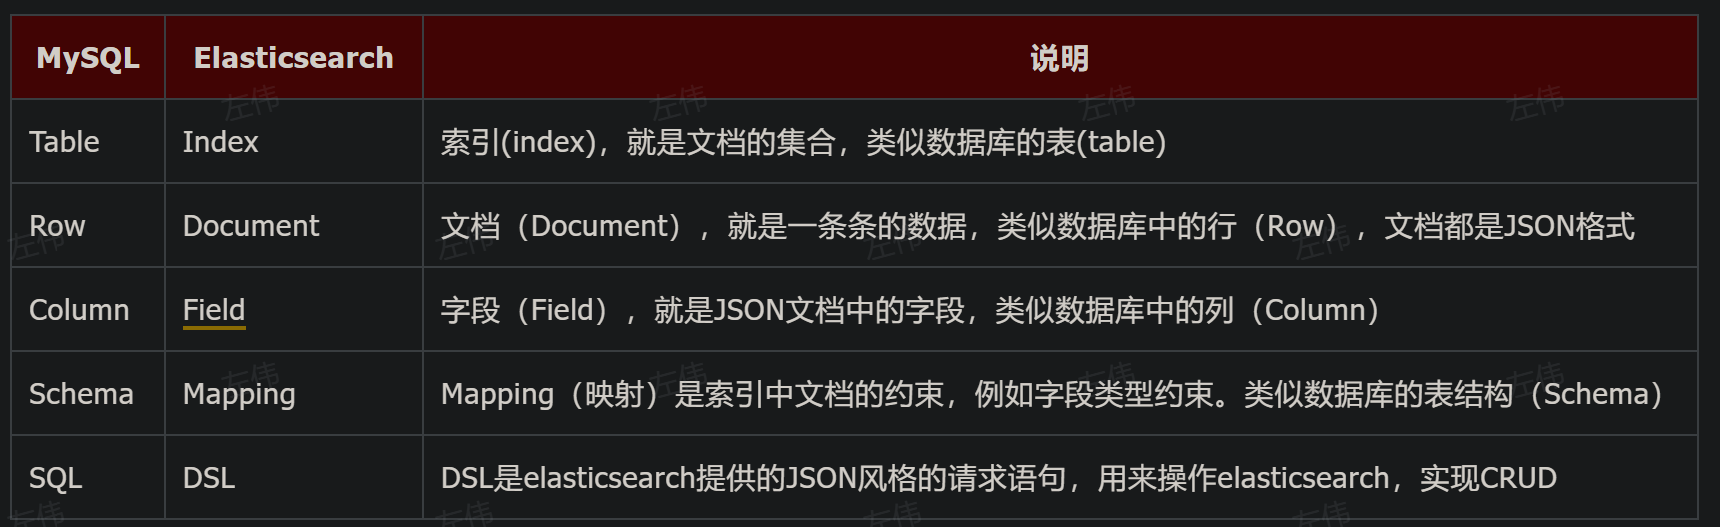
  • DSL查询:由es提供的基于JSON的DSL语句
    • 叶子查询:在特定字段中查询特定值
    • 符合查询:以逻辑方式组合多个叶子查询或者更改叶子查询的行为方式
    • 指定高亮字段:
      GET /{索引库名}/_search
      {
        "query": {
          "match": {
            "搜索字段": "搜索关键字"
          }
        },
        "highlight": {
          "fields": {
            "高亮字段名称": {
              "pre_tags": "<em>",
              "post_tags": "</em>"
            }
          }
        }
      }
  • 索引 :|725
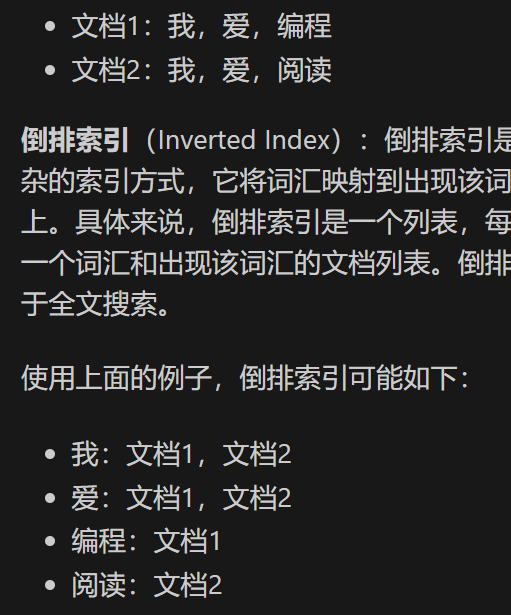
    • 倒排索引和正排索引的区别:
      • 正排索引是词条分到文档中
      • 倒排索引是给词条统计文档
      • |275
    • 使用索引模板来加快索引的创建与属性设置
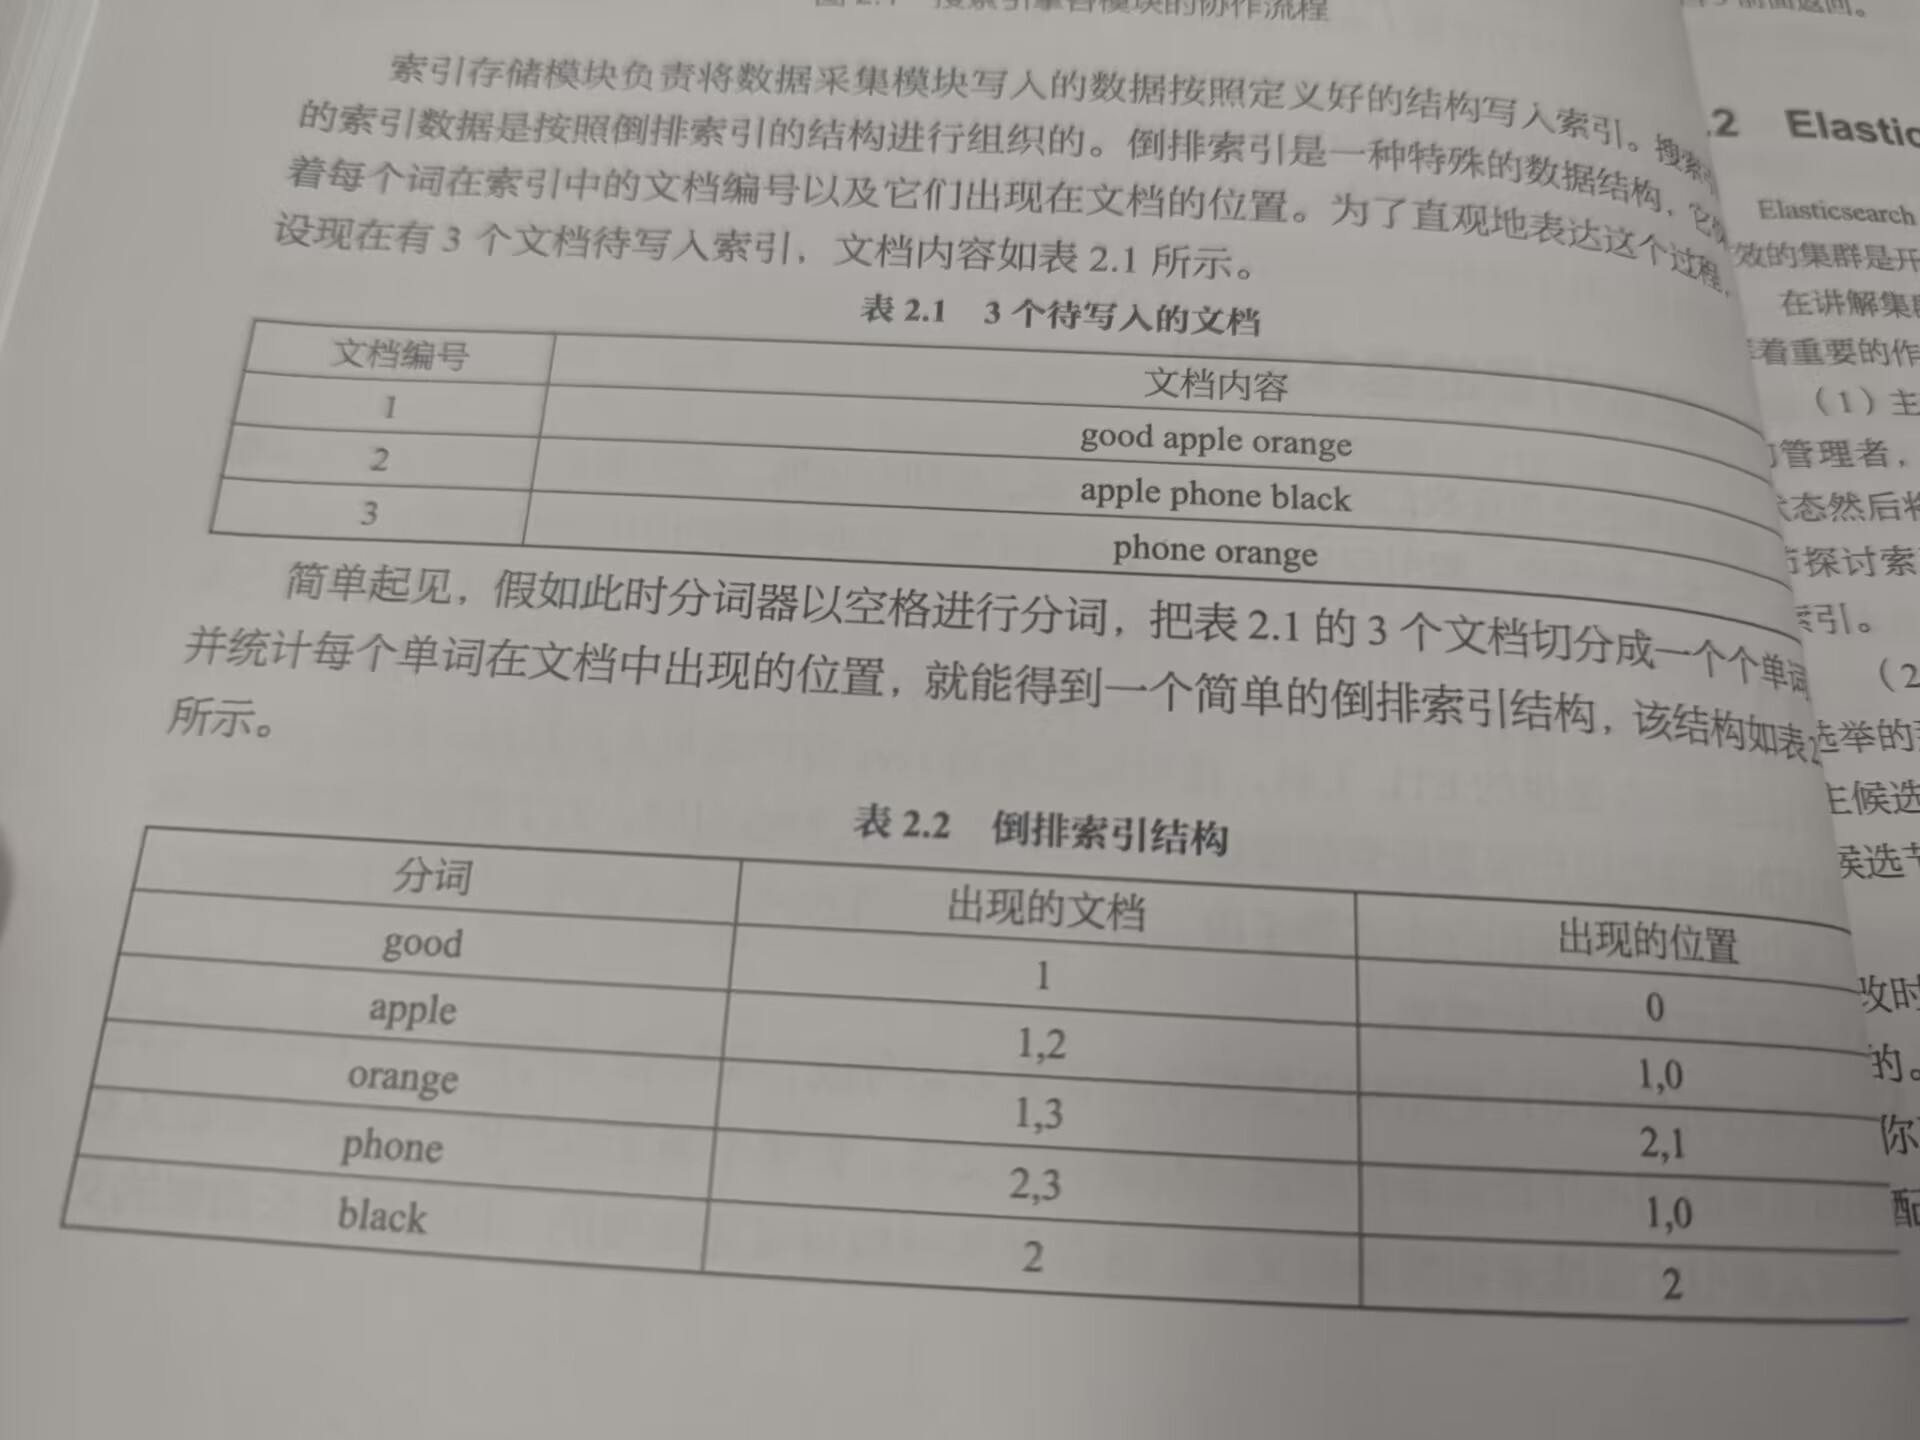
    • 索引结构:倒排索引,使用分词,记录每一个分词出现的文档编号和在文档中出现的位置
      • 搜索模块,路由值时,
    • 索引搜索:
      • 当搜索请求不带路由值时,接收到请求的节点成为协调节点,之后会选择使用的分片,之后会转发请求到拥有这些分片的节点上,每个分片产生一部分的局部结果汇总给协调节点,由协调节点汇总并排序之后返回。
      • 使用路由条件进行搜索时,会将请求转发,之后直接由选中的节点进行返回
    • 索引映射:
      • 相当于指定了索引字段的名字和能够存储的类型
      • 常用的数据类型:long , integer,short,byte,double,date(date可以在后面加一个format字段来执行时间的格式转换),keyword(用于保存原始文本,不会进行分词处理,用于精确匹配),boolean,geo_poinst经纬度类型,json格式(需要使用properties来指定内部对象的属性,实际存储时会使用 . 来表示层次结构),lists(数组)
      • **如何既能快速匹配,又能精确匹配?**,给字段添加一个fields参数,然后在里面放一个keyword字段
      • 在每一个字段的后面使用:”copy_to”:”复制出来的新字段名字” 可以做到复制这些字段的内容
PUT mysougoulog/_mapping 
{
  "properties":{
      "visitTime":{
        "type":"date",
        "format":"yyyy-MM-dd HH:mm:ss || epoch_millis",
        "ignore_malformed":true # 这个字段类型不对时,不写入,但是不影响其他字段的写入
      }
  }
}

# 二者兼得
PUT mysougoulog/_mapping 
{
    "properties":{
        "key":{
          "type":"text",
          "fields":{
            "keyword":{
              "type":"keyword",
              "ignore_above":256 # 表示256个字符后面的内容被忽略,用来节省字段
            }
          }
        }
    }
}
  • 文档:
    • CRUD时如何控制并发:
      • 修改时,加上?if_seq_no = xx&if_primary_term=xx来使用乐观锁来控制,这两个字段是可以查到的,Elastisearch不支持事务管理
    • 文本分析:
      • 文本分析需要经过>=0个字符过滤器一个分词器,>=0 个分词过滤器
        • 字符过滤器:对原始文档本进行转换,如去掉html标签
        • 分词器:按照规则切分为单词,
        • 分词过滤器:过滤掉一些没有用的词比如,的,删除停用词,也可进行分词的处理,如大小写转化,添加同义词
  • 分词器:
    • 创建倒排索引时对文档进行分词,用户搜索时,对输入的内容进行分词
    • IK分词器:
      • ik_smart 智能切分模式,粗粒度
      • ik_max_word:最细切分,细粒度
  • 数据:
    - 搜索数据:
    1. 精确搜索:搜索内容不经过文本分析直接进行文本匹配,适用于非text类,一般用于keyword字段
    2. 全文检索:对检索内容和字段都会进行文本分析
    3. 经纬度搜索,可以指定某个区域,例如⚪
    4. 复合搜索:
    - 布尔搜索:通过指定布尔逻辑条件来组织多条查询语句,同时满足整个布尔条件的才会被搜索出来
    - 等等
    - 父子关联:
    - 因为es会把数据折叠起来,使用点,所以当一个对象有多个相同的key时,不能进行搜索了,例如goods商品,里面存放商品id和生产时间,就会被折叠 警告: 避免使用对象数组
    - 解决方法:使用嵌套对象
    - 使用join字段来明确父子关系
    - 聚集统计:用于分析索引和文档,类似于mysql中的聚集操作

  • 集群:
    1. 新集群的产生:master节点的职责主要包括集群、节点和索引的管理,不负责文档级别的管理,主节点和数据节点不是一个
      • 初始化投票配置:将配置文件中的候选节点写入投票配置,所有节点均可参与投票
      • 选举主节点:超过半数就可成为主节点
      • 发现集群中的其他节点,节点尝试连接主节点,连接上之后主节点把最新的状态发布到这些节点中
      • 集群完成,对外启动统一的服务
    2. 集群状态的发布过程: 删除或者新增节点时触发
      • 主节点把最新的集群状态发送到每个节点上,每个节点将数据保存并向主节点发送确认响应
      • 主节点接收到半数以上的确认消息,开始提交,发送给每个节点通知使用最新的集群状态,子节点接收后发送确认响应,所有的都确认即可完成发布
      • 响应超过时间限制,则删除这个子节点
  • 如何实现master选举?
    • 对于所有可以成为master的节点,根据nodeId来排序,每个节点把自己直到的节点排一次序,然后选出第一个节点,认为他是master节点,入股某个节点到达可以成为超过master节点的一半,那就成为了master节点
  • 脑裂问题:
    • 设置最小主节点设置,设置的值应该是集群中节点总数的一半 + 1
  • 读写一致:
    • 版本控制:每个文档在ES中都有一个版本号,每次被修改后,版本号会增加,获取文档时,会同时或者它的版本号,更新时可以指定这个版本号,如果版本号不匹配,更新操作就会被拒绝
    • 刷新与同步:向ES中写入数据时,数据先被写入内存缓冲区,然后每隔一段时间刷新一次或者缓冲区满时被刷新到磁盘后就可以被搜索到了,但是没有被写入磁盘,之后定期同步到磁盘中,同步后就是持久化存储了
    • 副本和分片:只有主节点可以写入数据,然后被复制到副本分片中,读取数据时可以从任何一个包含该数据的分片中获取
    • 设置写入确认级别
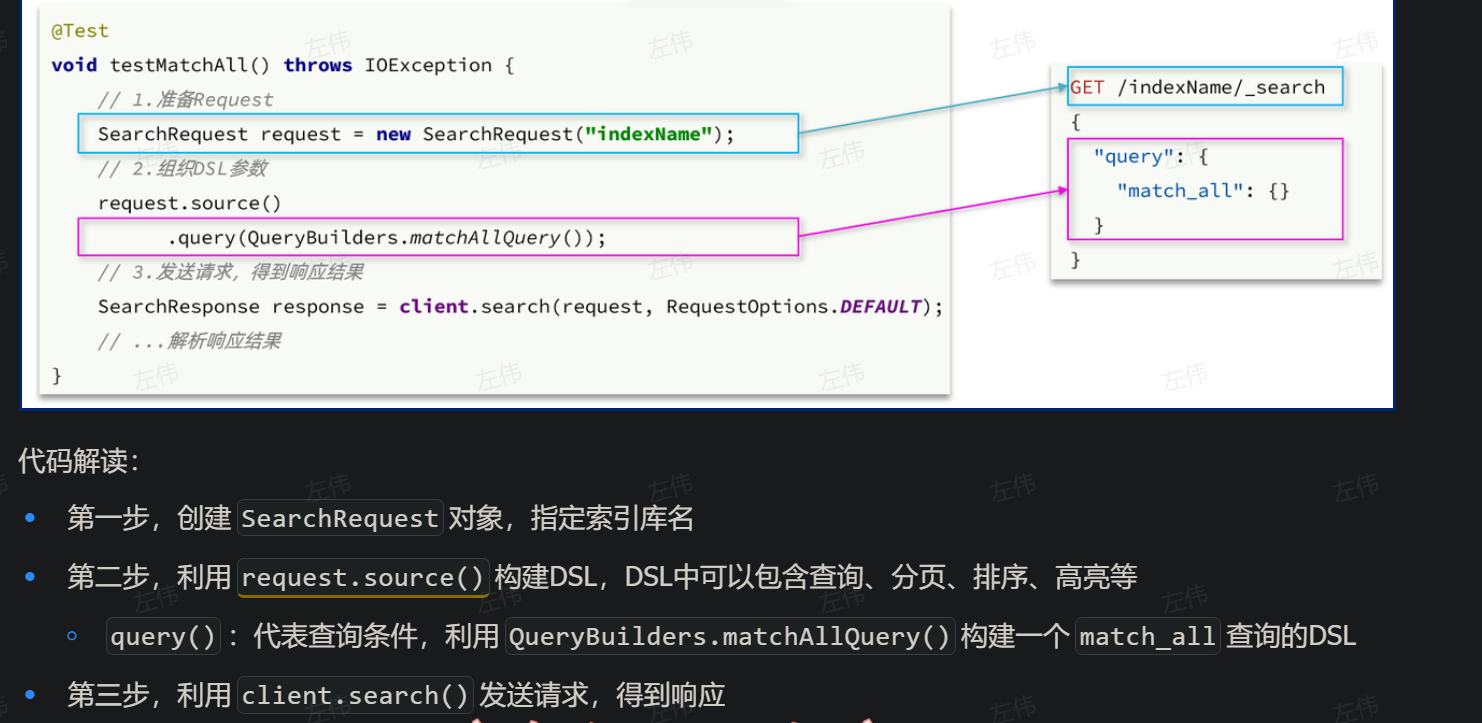
  • 代码中使用:|575
    @Test
    void testMatchAll() throws IOException {
        // 1.创建Request
        SearchRequest request = new SearchRequest("items");
        // 2.组织请求参数
        request.source().query(QueryBuilders.matchAllQuery());
        // 3.发送请求
        SearchResponse response = client.search(request, RequestOptions.DEFAULT);
        // 4.解析响应
        handleResponse(response);
    }
    
    private void handleResponse(SearchResponse response) {
        SearchHits searchHits = response.getHits();
        // 1.获取总条数
        long total = searchHits.getTotalHits().value;
        System.out.println("共搜索到" + total + "条数据");
        // 2.遍历结果数组
        SearchHit[] hits = searchHits.getHits();
        for (SearchHit hit : hits) {
            // 3.得到_source,也就是原始json文档
            String source = hit.getSourceAsString();
            // 4.反序列化并打印
            ItemDoc item = JSONUtil.toBean(source, ItemDoc.class);
            System.out.println(item);
        }
    }

MeiliSearch->轻量级的ES

ES虽然扩展性和实时性都比较好,但是中小型项目中,ES有些过剩,对设备的要求也比较高,可以使用MeiliSearch来替代。同时MeiliSearch本身就支持中文搜索,而无需配置